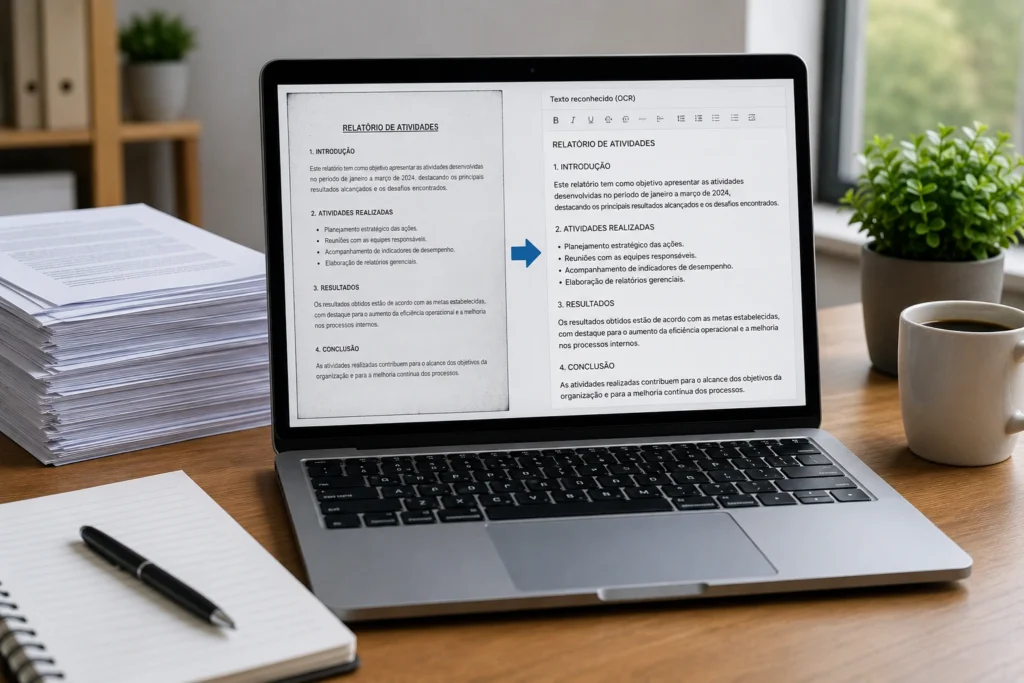
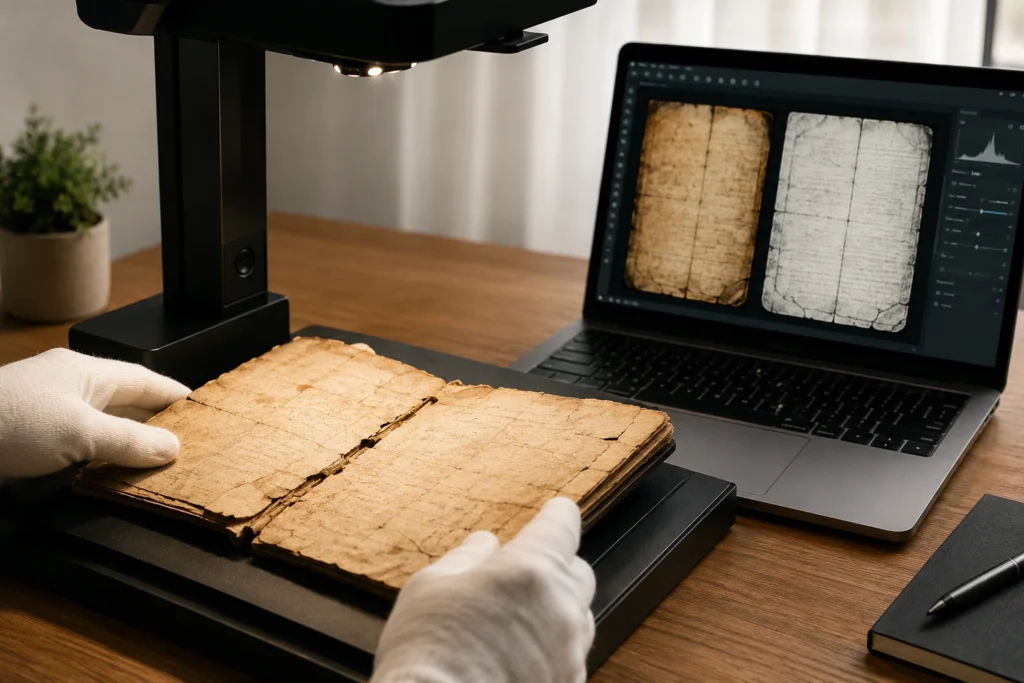
O OCR em documentos antigos transforma imagens de páginas desgastadas em texto pesquisável, copiável e editável. No entanto, manchas, tinta desbotada, rasgos, dobras e deformações podem dificultar o reconhecimento automático. O sistema analisa formas visuais; quando uma letra se mistura ao fundo ou aparece apenas parcialmente, ele precisa escolher entre padrões semelhantes e pode gerar palavras, números ou sinais incorretos.
Por isso, fazer OCR em páginas antigas exige mais do que simplesmente enviar um arquivo para uma ferramenta de reconhecimento. É necessário avaliar a qualidade da imagem, preparar uma cópia de trabalho, escolher configurações compatíveis com o idioma e o layout e revisar o resultado comparando-o com a página original. Este processo aumenta a utilidade do texto extraído sem transformar uma interpretação automática em uma transcrição considerada definitiva.
Por que o OCR em documentos antigos apresenta mais erros
O reconhecimento óptico de caracteres depende da identificação de padrões formados por linhas, curvas, espaços e contrastes. Em uma página recente, a tinta costuma se destacar do papel e os caracteres mantêm contornos relativamente regulares. Em um documento antigo, porém, o tempo pode alterar tanto o suporte quanto a impressão.
O papel pode ficar amarelado, manchado ou ondulado. A tinta pode perder intensidade, borrar ou desaparecer em pontos específicos. Além disso, uma captura inclinada ou feita sob iluminação irregular pode criar sombras que não pertencem ao conteúdo. Essas alterações fazem com que o OCR confunda elementos do fundo com letras ou deixe de reconhecer partes que ainda são visíveis para uma pessoa.
| Problema na página | Possível efeito no OCR | Cuidados recomendados |
|---|---|---|
| Manchas e amarelamento | Caracteres extras, pontuação indevida ou omissão de palavras | Testar escala de cinza e ajustes tonais moderados |
| Tinta desbotada | Letras incompletas e confusão entre caracteres semelhantes | Preservar tons intermediários e revisar trechos fracos |
| Rasgos e áreas arrancadas | Lacunas, palavras cortadas e linhas interrompidas | Marcar o conteúdo ausente em vez de completá-lo por suposição |
| Página inclinada ou deformada | Linhas misturadas e ordem de leitura incorreta | Corrigir rotação, perspectiva e, quando necessário, trabalhar por blocos |
| Colunas, tabelas e anotações | Conteúdo embaralhado ou associação incorreta entre campos | Selecionar o modo de layout adequado e separar regiões |
Manchas, sombras e amarelamento
Manchas de umidade, poeira, contato com capas e variações naturais do papel podem criar áreas escuras com formatos semelhantes aos de letras. Uma marca arredondada próxima a uma palavra pode ser interpretada como “o”; um risco fino pode parecer um hífen, um acento ou parte de uma letra. Quando a mancha atravessa um espaço, o OCR pode unir duas palavras ou inserir um caractere entre elas.
O amarelamento também reduz a diferença visual entre o fundo e a tinta. Em algumas páginas, a alteração é uniforme; em outras, o centro permanece mais claro enquanto as bordas ficam escuras. Essa variação pode fazer o reconhecimento funcionar em uma parte da folha e falhar em outra.
Os sinais desse problema aparecem no resultado como pontuação inesperada, letras isoladas, espaços incomuns e palavras que não fazem sentido no contexto. Porém, o contexto não deve ser usado sozinho para corrigir a transcrição. Uma palavra estranha pode ser resultado de uma mancha, mas também pode corresponder exatamente à grafia presente no documento.
Tinta desbotada e caracteres incompletos
A tinta pode perder intensidade por exposição à luz, contato frequente ou deterioração do material. Quando apenas uma parte do caractere desaparece, o OCR tenta associar os fragmentos restantes a uma forma conhecida. Um “m” incompleto pode ser lido como “n” ou como “rn”; um “c” pouco marcado pode parecer “e”; e um algarismo parcialmente apagado pode ser confundido com outro.
Esse tipo de falha merece atenção especial em nomes, datas, números e abreviações. A alteração de um único caractere pode mudar a identificação de uma pessoa, a referência de uma página ou a leitura de uma informação numérica. Se a forma não puder ser confirmada visualmente, o mais adequado é marcar a dúvida.
Rasgos, dobras e áreas ausentes
O OCR não consegue recuperar de forma confiável uma letra que não aparece na imagem. Ele pode interpretar os fragmentos ao redor, mas qualquer tentativa de reconstruir automaticamente a parte ausente deve ser tratada como hipótese, não como conteúdo comprovado.
Um rasgo no começo da linha pode remover a primeira letra de várias palavras. Uma dobra escura pode unir elementos que deveriam estar separados. Já uma área arrancada pode eliminar completamente um trecho. A imagem continua importante como registro visual, mas o texto extraído apresentará lacunas inevitáveis.
Inclinação, ondulação e perspectiva
Uma página inclinada altera a posição das linhas e dos espaços entre palavras. Em páginas com duas colunas, isso pode fazer o sistema começar em uma coluna, saltar para outra e retornar posteriormente ao trecho anterior. O resultado pode parecer um texto com muitos erros de ordem, mesmo quando várias palavras foram reconhecidas corretamente.
A ondulação provocada pela encadernação cria um problema mais localizado. Letras próximas à lombada podem ficar comprimidas ou curvadas, enquanto as áreas externas permanecem mais regulares. Uma mesma palavra pode ser reconhecida no centro da página e apresentar falhas perto da margem interna.
Entenda a diferença entre uma imagem digitalizada e um PDF pesquisável
Uma digitalização pode conter apenas uma fotografia ou imagem da página. Visualmente, o arquivo parece completo, mas o computador não reconhece automaticamente as palavras representadas pelos pixels. Nesse caso, uma busca por um nome ou termo específico não encontrará resultados dentro do documento.
O OCR acrescenta uma camada de texto associada à imagem. Essa camada permite selecionar, copiar e pesquisar o conteúdo. Entretanto, ela não substitui a imagem original nem garante que todos os caracteres tenham sido interpretados corretamente. Um PDF pesquisável pode conter erros em datas, acentos, nomes próprios e palavras localizadas em áreas danificadas.
A melhor prática é conservar as duas partes: a imagem, que mantém a aparência da página, e o texto reconhecido, que facilita a consulta. Quando surgir uma dúvida, a imagem deve ser a referência principal. O texto extraído funciona como uma camada de acesso e pesquisa, não como uma reprodução automaticamente perfeita.
Identifique o tipo de desgaste antes de iniciar o OCR
Nem todo problema visual deve ser tratado da mesma maneira. Um ajuste que ajuda a reduzir uma sombra pode apagar uma letra fraca; um filtro que reforça caracteres pode destacar uma mancha; e uma correção geométrica pode melhorar as bordas sem resolver a curvatura perto da lombada.
Antes de processar a página, observe se a dificuldade está concentrada no fundo, nos caracteres ou na estrutura da folha. Também verifique se há colunas, tabelas, títulos, legendas e anotações com orientações diferentes. Esse diagnóstico ajuda a definir se será melhor utilizar a página inteira ou dividir o material em regiões menores.
Como reconhecer problemas de contraste
Quando o papel está escuro e a tinta também apresenta tonalidade próxima, o OCR pode não distinguir as letras do fundo. Se os caracteres parecem apagados, mas continuam visíveis, uma versão em escala de cinza pode preservar detalhes que seriam eliminados em uma conversão imediata para preto e branco.
O baixo contraste costuma gerar linhas incompletas, palavras ausentes e confusões entre letras de formato parecido. O problema pode ser mais intenso em trechos expostos à luz ou em áreas próximas às bordas. Compare diferentes regiões da mesma página para verificar se a falha é geral ou localizada.
Como reconhecer danos físicos
Rasgos, furos, dobras profundas e bordas danificadas removem ou ocultam informação. Nesses casos, a melhoria da imagem pode facilitar a leitura dos fragmentos preservados, mas não reconstituirá o conteúdo perdido. O reconhecimento deve ser considerado parcial sempre que uma parte do caractere não estiver disponível.
Também é importante diferenciar uma área apenas fraca de uma área realmente ausente. A primeira pode melhorar com ajustes cuidadosos; a segunda precisa ser marcada como lacuna. Essa distinção evita que uma interpretação provável seja apresentada como se estivesse comprovada na página.
Prepare uma cópia da imagem para melhorar o reconhecimento
Trabalhe sempre sobre uma cópia e preserve o arquivo original sem alterações. A imagem original pode conter detalhes de cor, textura e contraste que serão necessários durante a revisão. As versões ajustadas devem ser consideradas arquivos de trabalho, não substitutos do registro inicial.
Recorte as bordas com segurança
Remova elementos externos que não fazem parte da página, como mesa, fundo do scanner, capa, sombras intensas e objetos próximos. Esses elementos podem ser interpretados como linhas ou caracteres. Ao mesmo tempo, evite um recorte apertado demais, pois palavras próximas à margem podem ser cortadas.
Carimbos, números de página, assinaturas e anotações laterais podem fazer parte do conteúdo. Antes de removê-los, defina o objetivo da transcrição. Se a intenção for reconhecer apenas o texto principal, crie uma cópia específica para esse fim, mas mantenha a imagem completa arquivada.
Ajuste brilho, contraste e escala de cinza
A escala de cinza costuma ser um ponto de partida útil porque mantém diferenças graduais entre tinta, papel e manchas. Uma letra desbotada pode aparecer como um tom intermediário e desaparecer quando a imagem é convertida diretamente para preto e branco.
O preto e branco pode funcionar bem quando o fundo está uniforme e a tinta apresenta separação clara. No entanto, um limite muito agressivo pode apagar traços finos, fechar o interior de letras e transformar manchas em blocos semelhantes a caracteres.
Faça ajustes moderados e compare o resultado com a versão original. A imagem mais escura nem sempre é a melhor. O objetivo é conservar os contornos reais das letras e reduzir interferências sem criar detalhes artificiais.
Corrija rotação e perspectiva
Endireite a página quando as linhas estiverem inclinadas. Margens, linhas impressas e blocos de texto podem servir como referências. Uma pequena rotação já pode ajudar a separar melhor as linhas e os parágrafos.
Se a captura foi feita de lado, corrija a perspectiva para reduzir a aparência trapezoidal da página. Porém, não confunda perspectiva com deformação causada pela encadernação. A primeira pode ser corrigida de modo relativamente uniforme; a segunda pode exigir tratamento por regiões.
A correção geométrica reposiciona elementos visíveis, mas não recupera letras ausentes. Seu objetivo é facilitar a análise do que realmente aparece na imagem, sem produzir uma aparência de continuidade onde existe uma falha física.
Escolha uma resolução adequada
Para textos impressos de tamanho comum, uma digitalização em torno de 300 dpi pode ser uma referência prática, desde que a captura esteja focada e bem iluminada. Letras pequenas, fontes finas ou detalhes muito degradados podem exigir uma resolução maior, mas o aumento do número de pixels não compensa uma imagem desfocada.
Ampliar artificialmente um arquivo pequeno ajuda na visualização, mas não cria informação nova. Os contornos gerados pela interpolação não devem ser tratados como detalhes comprovados do documento. Sempre compare a ampliação com a imagem original.
Configure o OCR conforme o idioma e o layout
Selecione o idioma correto
O idioma influencia o reconhecimento de acentos, combinações de letras e sinais de pontuação. Em português, caracteres como “ã”, “ç”, “ê” e “á” podem ser prejudicados quando a imagem está fraca ou quando o idioma selecionado não corresponde ao texto.
Documentos antigos também podem apresentar grafias históricas, abreviações e palavras que não são comuns atualmente. O OCR pode sinalizar essas formas como estranhas ou substituí-las por termos mais conhecidos. A transcrição deve preservar o que está visível, sem modernizar automaticamente a ortografia.
Se houver trechos em mais de um idioma, avalie se a ferramenta permite selecionar idiomas adicionais. Essa opção pode ajudar em citações ou passagens multilíngues, mas também pode aumentar a quantidade de interpretações possíveis para uma palavra danificada. Compare sempre o resultado com a imagem.
Escolha o modo de análise da página
Uma página com texto corrido pode ser processada como um bloco principal. Já uma página com duas colunas, tabela, legenda ou anotação lateral exige uma análise de layout diferente. Quando o modo escolhido não corresponde à estrutura real, as palavras podem estar corretas individualmente, mas aparecer na ordem errada.
Em tabelas, a posição de cada item faz parte do significado. Um resultado em texto corrido pode misturar cabeçalhos, linhas e colunas. Se a associação entre os campos for importante, conserve a imagem e revise visualmente cada relação.
Em páginas com várias áreas distintas, recortes independentes costumam oferecer maior controle. Separe, quando fizer sentido, o cabeçalho, o corpo do texto, a tabela, a legenda e as anotações. Cada bloco pode receber uma configuração mais compatível com seu conteúdo.
Faça o reconhecimento por blocos
Processar a página inteira é conveniente, mas um erro local pode influenciar a interpretação de toda a folha. Uma mancha sobre uma coluna ou uma tabela próxima ao texto principal pode alterar a ordem de leitura. O processamento por blocos limita esse efeito à região problemática.
Em uma página de duas colunas, processe cada coluna separadamente e preserve a ordem original. Em uma tabela, pode ser necessário trabalhar por linhas ou grupos de células, sempre verificando a relação entre os elementos. Em anotações manuscritas, um bloco separado evita que a escrita manual seja misturada ao texto impresso.
Nomeie os arquivos de modo claro, indicando página e região, como “pagina_12_coluna_esquerda” ou “pagina_12_tabela”. Essa organização facilita a comparação entre o resultado e a imagem completa.
Compare versões e revise o texto reconhecido
Uma única configuração pode favorecer algumas áreas e prejudicar outras. Por isso, é útil comparar versões processadas com diferentes ajustes de tonalidade, enquadramento ou layout. A comparação deve se concentrar em trechos difíceis, como nomes, datas, números, abreviações e palavras próximas a manchas.
Não escolha automaticamente a versão que apresenta mais palavras. Um resultado mais longo pode conter mais caracteres inventados ou uma ordem de leitura incorreta. Observe qual versão corresponde melhor às formas realmente visíveis na imagem.
Conferência de letras e números
Revise o documento na ordem das páginas e compare cada linha com a imagem correspondente. Alguns erros recorrentes incluem a confusão entre “m” e “rn”, “c” e “e”, “u” e “v”, além de caracteres que desaparecem perto de manchas.
Números merecem atenção adicional. Um algarismo incompleto pode alterar uma data, uma numeração ou outro registro. Não escolha a alternativa que parece mais provável apenas porque ela combina com o contexto. A correção deve se apoiar na forma visível ou em uma fonte de conferência claramente relacionada e identificada.
Nomes próprios e nomes de lugares não devem ser normalizados automaticamente. Uma grafia pouco comum pode ser legítima. Corrija apenas erros comprovados pela imagem e preserve formas que, embora incomuns, estejam legíveis no documento.
Marque trechos ilegíveis
Quando uma letra ou palavra estiver coberta, apagada ou ausente, indique a incerteza. Uma convenção simples pode usar colchetes, ponto de interrogação ou a anotação “[trecho ilegível]”. O mais importante é aplicar o padrão de forma consistente e explicar seu significado no projeto de transcrição.
Se apenas um caractere estiver comprometido, marque a posição específica. Por exemplo, uma sequência como “18_4” não deve ser completada automaticamente com um algarismo escolhido pelo contexto. Se o começo de uma palavra foi arrancado, registre apenas o fragmento preservado, sem inventar a quantidade de letras ausentes.
Separe três situações: erro evidente do OCR, leitura provável e conteúdo realmente ilegível. Um resultado com “rn” pode ser corrigido quando a imagem mostra claramente um “m”. Já uma letra parcialmente encoberta deve receber uma marca de dúvida, e uma área sem informação deve permanecer como lacuna.
Preserve a referência visual
Mantenha a imagem original, o resultado bruto do OCR e a transcrição revisada em arquivos relacionados. Essa separação permite identificar o que foi produzido automaticamente e o que foi corrigido manualmente.
Quando possível, associe cada trecho à página e à região correspondente. Se uma página foi dividida em blocos, registre a posição de cada bloco. Assim, uma palavra reconhecida na coluna direita não será confundida com outra localizada na coluna esquerda.
Uma anotação simples sobre decisões difíceis também pode ser útil. Registre, por exemplo, que um algarismo foi comparado com outras ocorrências da mesma página ou que uma letra permanece ilegível devido a um rasgo. Esse histórico torna a transcrição mais verificável.
Boas práticas para um fluxo de trabalho confiável
- Preserve o arquivo original antes de qualquer edição.
- Observe a página e identifique manchas, desbotamento, rasgos, inclinação e deformações.
- Faça um recorte seguro, mantendo as margens relevantes.
- Corrija rotação e perspectiva quando necessário.
- Teste versões colorida, em escala de cinza e, se apropriado, em preto e branco.
- Escolha o idioma e o modo de análise compatíveis com o conteúdo.
- Divida a página em blocos quando houver colunas, tabelas ou anotações distintas.
- Compare o texto extraído diretamente com a imagem.
- Corrija apenas erros visualmente comprovados.
- Marque lacunas e incertezas sem completar informações por suposição.
- Guarde a imagem, o OCR bruto e a versão revisada juntos.
Esse fluxo evita que uma alteração feita para melhorar o reconhecimento destrua a referência original. Também facilita repetir o processamento se uma nova configuração apresentar resultado melhor em determinado trecho.
Perguntas frequentes sobre OCR em páginas antigas
É possível fazer OCR em uma página parcialmente apagada?
Sim, desde que ainda existam partes suficientes dos caracteres. O sistema pode reconhecer áreas preservadas e produzir um resultado parcial nas regiões desbotadas. No entanto, ele não recupera com segurança uma letra que desapareceu completamente.
Ajustes de contraste, escala de cinza e recortes específicos podem ajudar quando o problema é apenas baixa visibilidade. Se houver perda física do papel, a transcrição deve indicar a lacuna.
Qual resolução é adequada para documentos desgastados?
Uma resolução próxima de 300 dpi pode atender a textos impressos de tamanho comum, desde que a captura esteja focada. Letras muito pequenas ou fontes finas podem exigir mais detalhes, mas uma resolução elevada não corrige desfoque, iluminação ruim ou informação ausente.
Compare sempre um trecho com tinta fraca, uma área manchada e uma sequência numérica antes de escolher o arquivo definitivo.
É melhor usar preto e branco ou escala de cinza?
A escala de cinza costuma ser um ponto de partida mais seguro porque preserva variações entre papel e tinta. O preto e branco pode funcionar bem em páginas limpas e com contraste definido, mas pode eliminar traços delicados ou destacar manchas.
A decisão deve ser baseada em testes com a própria página, não em uma regra fixa. Em alguns documentos, versões diferentes podem ser úteis para regiões diferentes.
Como reduzir manchas interpretadas como letras?
Primeiro, verifique se a marca pertence ao papel ou à tinta. Observe seu alinhamento, espessura e formato em comparação com os caracteres próximos. Depois, teste ajustes moderados e processe a região separadamente, mantendo a imagem original intacta.
Se a marca continuar ambígua, não corrija automaticamente com base apenas em uma palavra que pareça fazer sentido. Registre a dúvida e mantenha a referência visual.
O OCR reconhece escrita antiga ou manuscrita?
O desempenho varia de acordo com a tipografia, a legibilidade e a qualidade da captura. Tipos antigos impressos podem conter formas de letras diferentes das atuais. A escrita manuscrita apresenta uma dificuldade adicional porque cada pessoa desenvolve traços, abreviações e ligações próprias.
O reconhecimento pode ajudar a localizar fragmentos, mas nomes, datas e números manuscritos devem ser conferidos diretamente na imagem. Em áreas difíceis, a transcrição provisória com marcações de incerteza é mais adequada do que uma frase completada por अनुमान.
Conclusão: o OCR facilita a pesquisa, mas a imagem continua sendo a referência
O OCR em documentos antigos pode transformar páginas difíceis de consultar em arquivos pesquisáveis, mas a qualidade do resultado depende da informação que ainda está visível. Manchas, tinta desbotada, rasgos, dobras e deformações afetam o reconhecimento de maneiras diferentes. Identificar o tipo de desgaste antes do processamento ajuda a escolher ajustes mais cuidadosos.
Uma boa preparação inclui preservar o original, recortar as bordas com segurança, corrigir o alinhamento, testar diferentes versões tonais e selecionar configurações compatíveis com o idioma e o layout. Quando a página tem colunas, tabelas ou anotações, trabalhar por blocos pode reduzir erros de organização.
A etapa de revisão é indispensável. Letras, datas, números e nomes devem ser conferidos diretamente na imagem. Onde houver informação ausente ou dúvida real, a transcrição deve indicar a incerteza em vez de apresentar uma reconstrução como fato.
O resultado mais confiável combina texto pesquisável, imagem original e registro das correções realizadas. Assim, o OCR cumpre sua função de facilitar a localização e a consulta, sem substituir a evidência visual do documento antigo. Antes de publicar ou compartilhar uma transcrição, revise os trechos críticos e mantenha os arquivos relacionados organizados para futuras conferências.