Diferença entre OCR e PDF pesquisável: entenda como cada recurso funciona
A diferença entre OCR e PDF pesquisável está principalmente no papel que cada conceito desempenha. OCR é a tecnologia usada para reconhecer caracteres presentes em uma imagem, enquanto um PDF pesquisável é um arquivo que contém texto interpretável pelo computador e permite localizar ou selecionar palavras. Os dois recursos costumam aparecer no mesmo processo de digitalização, mas não são sinônimos.
Essa distinção é importante para quem precisa organizar documentos digitalizados, localizar informações em várias páginas ou copiar trechos de contratos, recibos, formulários e outros arquivos. Um PDF pode ter sido submetido ao OCR sem se tornar pesquisável, assim como um PDF pode ser pesquisável sem ter passado por OCR. Tudo depende da origem do documento e da forma como o texto foi incorporado ao arquivo.
O que é OCR?
OCR é a sigla, em inglês, para Optical Character Recognition, ou reconhecimento óptico de caracteres. Trata-se de uma tecnologia capaz de analisar uma imagem e identificar nela letras, números, sinais de pontuação e outros elementos que formam um texto.
Quando uma página é escaneada, o resultado inicial costuma ser uma imagem. Para uma pessoa, as palavras podem estar perfeitamente visíveis. Para o computador, porém, aquela página pode ser apenas um conjunto de pontos, cores e formas, sem caracteres individuais que possam ser pesquisados ou copiados.
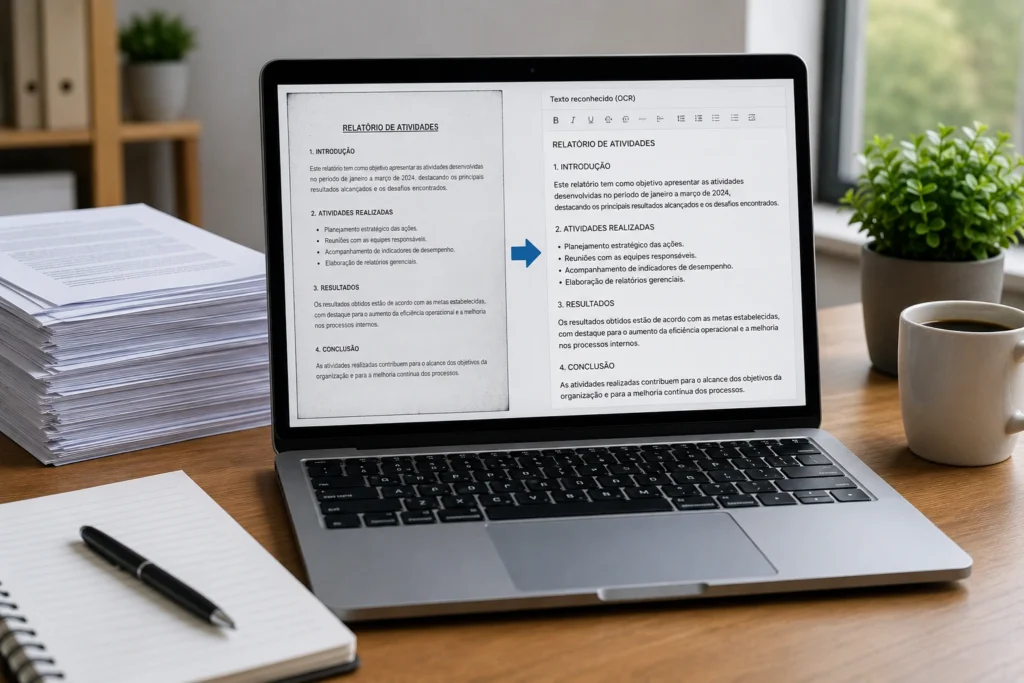
O OCR tenta interpretar esses elementos visuais. Depois do reconhecimento, o sistema gera uma representação textual que pode ser exportada para um arquivo de texto, inserida em um editor ou incorporada ao próprio PDF. Portanto, OCR descreve um processo de conversão e interpretação, não um tipo específico de arquivo.
Como o reconhecimento óptico de caracteres funciona
O processo começa com a análise da imagem. O sistema procura regiões que tenham aparência de texto e tenta separar palavras, linhas, colunas e outros componentes da página. Em seguida, compara os padrões encontrados com modelos de letras, números e símbolos.
Em uma página com a frase “Valor total: R$ 250,00”, por exemplo, o OCR precisa identificar as letras de “Valor”, reconhecer a palavra “total”, interpretar o símbolo da moeda, distinguir os algarismos e preservar a pontuação. Cada elemento é analisado com base em seu formato, posição e relação com os caracteres próximos.
Alguns sistemas também corrigem problemas comuns da imagem, como inclinação da página, rotação, contraste insuficiente ou pequenas imperfeições. Essas correções podem melhorar o resultado, mas não eliminam completamente a possibilidade de erros. O OCR interpreta uma representação visual; ele não recupera automaticamente um arquivo original perfeito.
O OCR pode reconhecer mais do que texto corrido
Além de parágrafos, o OCR pode identificar títulos, listas, campos de formulários, números, tabelas e textos distribuídos em colunas. Entretanto, reconhecer os caracteres não significa necessariamente preservar a organização visual da página.
Em uma tabela com colunas de descrição, quantidade e valor, o sistema pode identificar corretamente todas as palavras e números, mas organizar o texto extraído em uma sequência diferente da leitura visual. O conteúdo foi reconhecido, porém a estrutura da tabela pode não ser reproduzida com exatidão.
O mesmo pode acontecer em formulários. Um nome, uma data e um número podem estar posicionados em campos separados, mas aparecer juntos ou em uma ordem inesperada no texto copiado. Por isso, a qualidade do OCR deve ser avaliada não apenas pela quantidade de palavras reconhecidas, mas também pela organização do resultado.
O que é um PDF pesquisável?
Um PDF pesquisável é um arquivo que contém uma camada de texto reconhecível pelo computador. Essa camada permite usar a busca do leitor de PDF, selecionar palavras e, em muitos casos, copiar trechos para outro aplicativo.
O documento pode ter sido criado originalmente em um editor de texto, em um sistema de gestão ou em outro programa digital. Também pode ter começado como uma digitalização e recebido uma camada textual depois da aplicação de OCR.
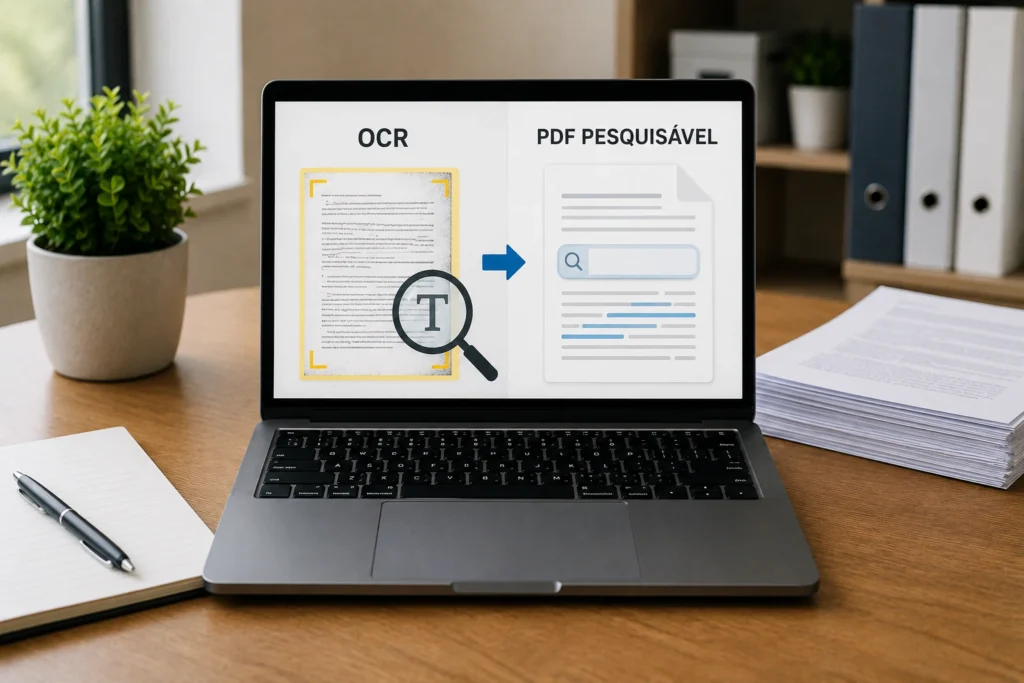
Em um PDF pesquisável criado a partir de uma página escaneada, a imagem original geralmente continua sendo preservada. O texto reconhecido é associado às regiões correspondentes da página e pode ficar praticamente invisível durante a leitura. Assim, o usuário continua vendo a aparência da digitalização, mas o programa consegue localizar as palavras.
Como funciona a camada de texto
A camada de texto é uma estrutura interna que relaciona caracteres reconhecíveis às posições em que eles aparecem na página. Quando o leitor procura uma palavra, ele consulta essa estrutura e destaca a região correspondente na imagem ou no conteúdo visual do PDF.
Imagine um contrato digitalizado que contenha a expressão “prazo de pagamento”. Se o documento tiver uma camada textual adequada, a busca por essa expressão poderá localizar a página e destacar o trecho. A aparência do contrato, incluindo carimbos, assinaturas e espaçamentos, pode continuar baseada na imagem original.
Essa camada não precisa substituir a imagem. Em muitos arquivos, a imagem é mantida como representação principal, enquanto o texto funciona como uma camada auxiliar para pesquisa e seleção. Por esse motivo, o PDF pode parecer exatamente igual antes e depois do reconhecimento, mesmo tendo adquirido novas funcionalidades.
Um PDF pesquisável é necessariamente editável?
Não. Pesquisar, selecionar e copiar texto são funções diferentes de editar o conteúdo original. Um PDF pode permitir a seleção de uma palavra sem oferecer uma edição equivalente à de um documento criado em um editor de texto.
Em uma digitalização com camada textual, as letras visíveis podem continuar fazendo parte de uma imagem. Se o usuário alterar ou substituir o texto selecionado, isso não significa necessariamente que a imagem da página será modificada. Para editar o conteúdo visual, pode ser necessário utilizar recursos específicos de edição ou reconstruir o documento.
Também é possível que o texto copiado apresente erros ou quebras de linha inadequadas, mesmo quando a aparência da página está correta. Portanto, a capacidade de edição não deve ser usada como critério único para definir se um PDF é pesquisável.
Diferença entre OCR e PDF pesquisável
A diferença entre OCR e PDF pesquisável pode ser resumida pela relação entre processo e resultado. OCR é o processo que transforma padrões visuais em informação textual. PDF pesquisável é o arquivo que disponibiliza texto interpretável para busca e seleção.
| Aspecto | OCR | PDF pesquisável |
|---|---|---|
| O que é | Uma tecnologia ou processo de reconhecimento de caracteres. | Um arquivo que contém texto localizável e, geralmente, selecionável. |
| Função principal | Interpretar texto presente em uma imagem. | Permitir busca, seleção e possível cópia do texto. |
| Resultado possível | Arquivo de texto, transcrição ou camada incorporada ao PDF. | Documento digital com estrutura textual reconhecível. |
| Depende de uma imagem? | Normalmente, sim, quando é usado para digitalizações. | Não necessariamente; o PDF pode ter sido criado diretamente com texto digital. |
| Garante precisão total? | Não. O reconhecimento pode conter erros. | Não. O arquivo pode ser pesquisável e ainda conter falhas na camada textual. |
| Garante edição? | Não. | Não. Pesquisa e edição são funções diferentes. |
OCR é o processo; PDF pesquisável é uma característica do arquivo
Se uma página escaneada for analisada por OCR e o texto reconhecido for salvo em um arquivo separado, houve uso de OCR, mas o PDF original pode continuar sem pesquisa textual. Nesse caso, a tecnologia foi aplicada, porém o resultado não foi incorporado ao documento de origem.
Por outro lado, um PDF criado diretamente a partir de um editor de texto já pode ser pesquisável desde o início. Como os caracteres foram gerados digitalmente, não foi necessário reconhecer uma imagem. O arquivo tem texto pesquisável, mas não necessariamente passou por OCR.
Também existem fluxos em que o OCR é aplicado e a camada de texto é incorporada ao PDF. Essa é uma forma comum de converter uma digitalização em um arquivo pesquisável sem alterar significativamente a aparência da página.
Por que um PDF escaneado pode não permitir pesquisas?
Um PDF escaneado pode armazenar cada página apenas como uma imagem. Nesse cenário, as letras estão visíveis para os olhos, mas não existem como caracteres separados dentro do arquivo. O leitor de PDF não tem uma estrutura textual para consultar.
Ao pressionar Ctrl + F e procurar uma palavra, o programa verifica o conteúdo textual disponível no documento. Se houver apenas imagens, a busca não encontrará termos visíveis na página. A situação pode ocorrer com contratos, comprovantes, formulários, livros digitalizados e outros materiais convertidos por escaneamento.
A seleção apresenta um comportamento semelhante. Em vez de marcar palavras individualmente, o leitor pode não selecionar nada ou tratar a página como um único elemento visual. Copiar um endereço, uma data ou um parágrafo exige, então, a digitação manual ou a aplicação de uma tecnologia de reconhecimento.
Visualizar texto não é o mesmo que ter texto digital
A aparência de uma página não revela sua estrutura interna. Duas versões visualmente idênticas podem funcionar de maneiras diferentes: uma pode conter somente uma imagem, enquanto a outra pode ter a mesma imagem acompanhada por uma camada textual.
Na primeira versão, a busca não localiza palavras e a seleção textual não funciona adequadamente. Na segunda, o usuário pode pesquisar termos e copiar trechos, ainda que o conteúdo extraído tenha alguma diferença de formatação.
Essa distinção também é relevante para acessibilidade. Leitores de tela dependem de informações textuais e de uma estrutura documental adequada para interpretar o conteúdo. Uma imagem sem texto alternativo ou sem camada reconhecível pode dificultar o acesso automatizado às informações da página.
Como verificar se um PDF é pesquisável
A forma mais simples de verificar o arquivo é escolher uma palavra claramente visível e usar a função de busca do leitor de PDF. Títulos, nomes de seções e palavras impressas em tamanho maior costumam ser bons exemplos para o teste.
- Abra o arquivo em um leitor de PDF confiável.
- Escolha uma palavra nítida e completa na página.
- Use a busca do programa para procurar exatamente esse termo.
- Observe se a ocorrência é encontrada na posição correta.
- Tente selecionar uma palavra ou uma frase curta.
- Cole o conteúdo em um editor de texto simples para verificar o resultado.
Se a busca localizar a palavra e a seleção marcar caracteres individuais, há um forte indício de que o arquivo contém texto pesquisável. Caso nada seja encontrado, o PDF pode ser formado apenas por imagens. Ainda assim, um único teste não é suficiente para avaliar todo o documento.
Uma página pode ter recebido OCR enquanto outra não. Isso acontece quando o arquivo reúne páginas de origens diferentes ou quando a qualidade de determinadas imagens impediu o reconhecimento. O ideal é testar mais de uma página, especialmente aquelas com formatação e nitidez distintas.
Busca e seleção não comprovam a precisão do texto
Um PDF pode ser pesquisável e conter erros na camada textual. Por exemplo, um número pode ser confundido com uma letra, uma pontuação pode desaparecer ou uma palavra pode ser dividida de maneira inadequada.
Se a informação for importante para consulta, organização ou conferência, compare o trecho selecionado com a imagem original. Dê atenção especial a nomes, datas, valores, números de identificação, abreviações e símbolos.
Em documentos com tabelas e colunas, verifique também a ordem do conteúdo copiado. O texto pode estar disponível para pesquisa, mas ser apresentado em uma sequência diferente daquela observada visualmente.
O que influencia a qualidade do OCR?
A qualidade do reconhecimento depende de diversos fatores. Imagens nítidas, completas e bem alinhadas tendem a produzir resultados mais consistentes, enquanto páginas com problemas visuais aumentam a possibilidade de divergências.
- Resolução: imagens muito pequenas podem não oferecer detalhes suficientes para distinguir letras e números.
- Contraste: texto apagado, fundo escuro ou variações de iluminação podem dificultar a identificação dos caracteres.
- Inclinação: páginas tortas podem prejudicar a separação das linhas e das palavras.
- Manchas e sombras: marcas sobre as letras podem alterar o formato interpretado pelo sistema.
- Tipografia: fontes ornamentadas, muito pequenas ou pouco definidas exigem uma análise mais complexa.
- Manuscrito: textos escritos à mão podem ser mais difíceis de reconhecer do que textos digitados.
- Layout: tabelas, colunas e campos separados podem afetar a ordem do conteúdo extraído.
- Idioma: configurações inadequadas podem dificultar o reconhecimento de acentos e caracteres específicos.
Erros semelhantes visualmente também são comuns. O sistema pode confundir “0” com “O”, “1” com “I”, ou interpretar uma vírgula como um ponto quando a imagem não está suficientemente definida. Esses problemas não significam necessariamente que o OCR falhou por completo; indicam que o resultado precisa de conferência.
Exemplos práticos de OCR e PDF pesquisável
Contrato digitalizado
Considere um contrato impresso que foi escaneado. Na primeira versão, cada página contém apenas uma imagem. A busca por uma cláusula não retorna resultados, e o texto não pode ser copiado de maneira convencional.
Depois da aplicação de OCR com incorporação da camada textual, a aparência do contrato pode permanecer a mesma. A diferença é que termos como “vigência”, “pagamento” ou “rescisão” passam a ser localizáveis. Mesmo assim, qualquer trecho relevante deve ser conferido na imagem para evitar depender de um reconhecimento incorreto.
Recibo digitalizado
Em um recibo com a informação “Total: R$ 250,00”, o OCR pode reconhecer a palavra “Total” e o valor. Caso a imagem esteja nítida, a cópia poderá ser bastante próxima do original. Se houver baixa resolução ou manchas, o sistema pode alterar a pontuação ou confundir algum algarismo.
O PDF será pesquisável se o texto reconhecido estiver incorporado ao arquivo. Se o resultado for exportado apenas para um documento separado, o PDF original continuará funcionando como uma imagem sem pesquisa interna.
Formulário com campos e tabelas
Em um formulário, o sistema pode reconhecer nomes, datas e números, mas não preservar a relação visual entre cada informação e seu respectivo campo. O conteúdo extraído pode aparecer em uma ordem diferente da página, sobretudo quando há várias áreas preenchidas.
Esse tipo de arquivo pode ser perfeitamente pesquisável e, ao mesmo tempo, exigir revisão para uso em planilhas, sistemas de cadastro ou outros documentos. A busca textual e a organização dos dados são características relacionadas, mas não idênticas.
Como escolher o resultado adequado
O melhor formato depende do objetivo do documento. Se a finalidade for apenas localizar palavras em várias páginas, um PDF com camada textual pode ser suficiente. Se for necessário reutilizar os dados em um sistema, talvez seja mais apropriado exportar o conteúdo para um formato estruturado e revisar a organização.
| Objetivo | Resultado mais adequado | Ponto de atenção |
|---|---|---|
| Pesquisar termos dentro da digitalização | PDF com camada de texto pesquisável | Verificar se as palavras foram reconhecidas corretamente. |
| Copiar pequenos trechos | PDF pesquisável ou texto extraído | Conferir quebras de linha, acentos e pontuação. |
| Preservar a aparência da página | Imagem original acompanhada por camada textual | A camada pode conter erros mesmo quando a imagem está fiel. |
| Reutilizar dados em sistemas | Texto estruturado ou planilha revisada | Tabelas e campos podem exigir reorganização manual. |
| Manter o conteúdo acessível | PDF com texto reconhecível e estrutura adequada | A camada de texto é importante, mas não substitui toda a revisão de acessibilidade. |
Perguntas frequentes sobre OCR e PDF pesquisável
Todo PDF criado com OCR se torna pesquisável?
Não. O OCR pode gerar uma transcrição ou um arquivo separado sem modificar o PDF original. Para que o documento seja pesquisável, o texto reconhecido precisa ser incorporado ao próprio PDF em uma estrutura que o leitor consiga consultar.
É possível transformar um PDF escaneado em pesquisável?
Sim. O arquivo pode ser submetido ao reconhecimento de caracteres e salvo novamente com uma camada textual associada às páginas. Depois da conversão, é importante testar a busca, a seleção e a fidelidade de trechos relevantes.
Um PDF pesquisável permite editar o conteúdo?
Não necessariamente. A pesquisa e a seleção indicam que existe texto interpretável, mas não garantem que as letras visíveis possam ser alteradas diretamente. Em muitos documentos digitalizados, a imagem continua sendo a representação principal da página.
Por que o OCR pode apresentar erros?
O OCR interpreta padrões visuais e pode ter dificuldades com baixa resolução, manchas, sombras, inclinação, fontes incomuns, manuscritos, tabelas e caracteres parecidos. A conferência com a imagem original é recomendável quando houver necessidade de precisão.
Um PDF sem pesquisa pode conter texto em algumas páginas?
Sim. Um arquivo pode reunir páginas digitais e páginas escaneadas, ou ter recebido OCR apenas em parte do conteúdo. Por isso, vale testar diferentes páginas e não presumir que todo o documento tenha o mesmo tipo de estrutura.
A camada de texto sempre fica visível?
Não. Em muitos PDFs pesquisáveis, a camada textual fica sobreposta à imagem de forma praticamente invisível. Ela existe para permitir busca e seleção, enquanto a página continua sendo exibida com a aparência da digitalização.
Conclusão: OCR e PDF pesquisável cumprem funções diferentes
OCR e PDF pesquisável estão relacionados, mas não representam a mesma coisa. OCR é a tecnologia que reconhece caracteres em uma imagem e transforma esses padrões em informação textual. PDF pesquisável é o arquivo que contém essa informação de forma utilizável para localizar e, geralmente, selecionar palavras.
Uma digitalização pode passar por OCR sem que o texto seja incorporado ao PDF. Da mesma forma, um PDF pode ser pesquisável desde a origem, sem qualquer reconhecimento de imagem. A maneira mais segura de identificar o resultado é testar a busca e a seleção, além de comparar o conteúdo extraído com a página visual.
Ao lidar com contratos, recibos, formulários ou outros documentos digitalizados, considere tanto a funcionalidade quanto a precisão. Um arquivo pesquisável facilita a localização das informações, mas a camada textual pode conter erros de reconhecimento e não preservar perfeitamente a ordem de tabelas ou colunas. Com essa diferença em mente, fica mais fácil escolher o formato adequado e revisar o conteúdo antes de utilizá-lo.