Como saber se um PDF tem OCR é uma dúvida comum quando um documento parece legível, mas não permite selecionar, pesquisar ou copiar as palavras. A aparência da página, por si só, não revela se o arquivo contém texto real. Um PDF pode mostrar letras nítidas e ainda ser formado apenas por imagens escaneadas. Também pode conter uma camada de texto reconhecido sobre a imagem, permitindo pesquisas mesmo que o visual original permaneça praticamente igual.
Essa verificação é útil antes de tentar converter, editar ou extrair o conteúdo de um arquivo. Com alguns testes no próprio navegador, é possível identificar se o PDF não tem texto interpretável, se possui OCR parcial ou se já contém texto pesquisável desde a sua criação. Os resultados não informam necessariamente qual programa foi usado, mas ajudam a entender a estrutura do documento e a escolher o próximo procedimento.
Como saber se um PDF tem OCR pelo navegador
O navegador costuma oferecer recursos suficientes para uma avaliação inicial. Os principais testes envolvem selecionar uma palavra, pesquisar um termo e copiar um trecho para outro editor. Cada procedimento observa um comportamento diferente do PDF, e a combinação dos resultados é mais confiável do que qualquer teste isolado.
Antes de começar, abra o arquivo em um visualizador de PDF atualizado. Escolha uma página com texto corrido, outra com números ou datas e, se possível, uma página que tenha tabelas ou diferentes tipos de conteúdo. Essa variedade é importante porque o reconhecimento pode ter sido aplicado somente a algumas páginas ou apresentar qualidade desigual em regiões distintas.
1. Tente selecionar palavras na página
Com o PDF aberto, posicione o cursor sobre uma palavra visível e arraste para selecionar uma linha ou um pequeno parágrafo. Em um documento que contém texto interpretável, o destaque costuma acompanhar palavras, linhas ou blocos de caracteres. Dependendo do visualizador, o cursor também pode assumir o formato normalmente usado para seleção de texto.
Se a página inteira se comportar como uma única imagem, sem permitir o destaque de palavras, há uma indicação de que aquele trecho não possui uma camada textual acessível. O mesmo pode ocorrer quando o arquivo foi produzido a partir de uma digitalização sem reconhecimento de caracteres.
O resultado não deve ser interpretado de maneira absoluta após um único teste. Um PDF pode misturar páginas digitais, imagens escaneadas e páginas com OCR. Também é possível que somente o cabeçalho contenha texto selecionável, enquanto o corpo da página continue sem reconhecimento. Por isso, repita a seleção em diferentes áreas e páginas.
2. Use a pesquisa interna do visualizador
Abra o recurso de busca do visualizador, normalmente representado por uma lupa ou acessado pelo atalho de pesquisa do navegador. Digite uma palavra que esteja claramente visível na página, como o título de uma seção ou um termo relativamente longo.
Quando o visualizador encontra a palavra e destaca uma região correspondente, existe um forte indício de que o PDF contém caracteres pesquisáveis. O resultado pode aparecer ligeiramente deslocado em relação às letras da imagem. Isso é comum quando a camada de texto foi criada sobre uma página escaneada e não ficou perfeitamente alinhada.
Para tornar o teste mais útil, pesquise termos de naturezas diferentes:
- Uma palavra comum que apareça no texto corrido.
- Uma palavra com acento, para observar como os sinais gráficos foram reconhecidos.
- Uma data ou sequência numérica.
- Uma palavra que apareça somente uma vez no documento.
- Um termo localizado em outra página, para verificar se o reconhecimento é abrangente.
Se a busca não encontrar uma palavra visível, isso pode significar que a página não possui OCR. Porém, também pode indicar uma falha específica de reconhecimento, uma diferença de acentuação ou um erro de digitação no termo pesquisado. Portanto, faça mais de uma tentativa antes de concluir que o arquivo não contém texto.
3. Copie um trecho e cole em um editor
Selecione uma frase curta, copie-a e cole o resultado em um editor de texto disponível no computador. O conteúdo colado pode mostrar se o visualizador conseguiu fornecer caracteres e também revelar a qualidade da camada textual.
Observe se as palavras aparecem completas, se os espaços foram preservados e se a ordem das linhas é compreensível. Um PDF com OCR pode produzir texto com acentos ausentes, caracteres trocados, palavras unidas ou quebras de linha inesperadas. Esses problemas não significam necessariamente que o arquivo não tenha OCR; podem indicar apenas que o reconhecimento apresenta limitações.
Por exemplo, uma imagem pode mostrar “Data do documento: 12/04/2024”, enquanto a cópia resulta em “Data do documento: 12/04/2024” ou em uma versão com algum algarismo incorreto. Nos dois casos, a existência de caracteres copiados indica que aquela região não é apenas uma imagem sem texto associado.
Faça o teste em pelo menos dois pontos da página e em páginas diferentes. Se um trecho puder ser copiado e outro não, o documento provavelmente apresenta reconhecimento parcial ou estruturas distintas entre as páginas.
O que é OCR e como ele aparece em um PDF
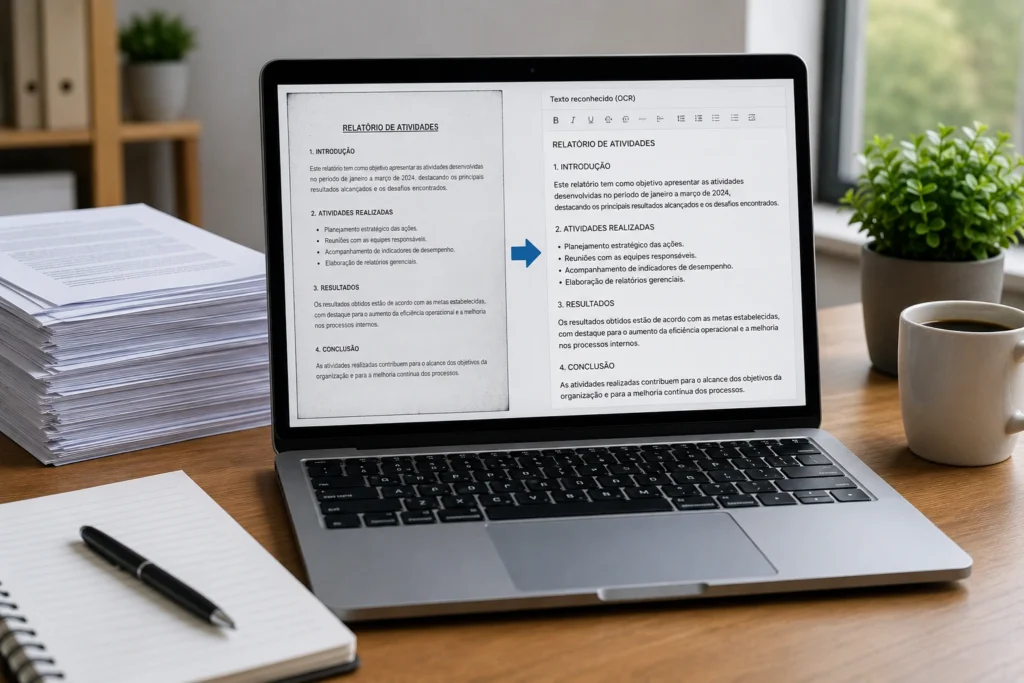
OCR é a sigla, em inglês, para reconhecimento óptico de caracteres. A tecnologia analisa uma imagem que contém letras, números e outros símbolos e tenta criar uma representação textual correspondente. Em um PDF escaneado, o resultado geralmente é uma camada de texto posicionada sobre a imagem original.
Essa camada pode ficar praticamente invisível para quem lê o documento. A página continua com a mesma aparência do escaneamento, incluindo fontes, carimbos, marcas e eventuais imperfeições. A diferença aparece quando o usuário tenta pesquisar, selecionar ou copiar palavras.
O OCR não transforma automaticamente o PDF em um documento totalmente editável. Em muitos casos, ele apenas acrescenta caracteres para facilitar a busca e a extração. A imagem continua sendo responsável pela aparência principal da página, enquanto o texto reconhecido funciona como uma camada associada às posições observadas pelo sistema.
A precisão depende de vários fatores, como resolução da imagem, contraste, inclinação da página, qualidade da impressão, tipo de fonte, presença de tabelas e organização do conteúdo. Documentos com duas colunas, campos preenchidos, símbolos ou números pequenos podem gerar uma cópia menos organizada mesmo quando o OCR está presente.
PDF formado apenas por imagens
Em um PDF criado somente a partir de páginas escaneadas, cada folha funciona como uma imagem. As letras visíveis fazem parte dos pixels da página, assim como fotografias, carimbos e marcas do papel. O visualizador consegue exibir a imagem, mas não identifica automaticamente onde estão as palavras.
Nessa situação, ampliar o zoom melhora a visualização, mas não cria texto selecionável. A busca interna normalmente não localiza termos que aparecem apenas na imagem, e a tentativa de copiar a página não produz o conteúdo escrito. Esses sinais, observados em conjunto, são compatíveis com um PDF sem camada textual.
PDF com OCR
Quando o OCR foi aplicado, o documento pode continuar visualmente idêntico ao escaneamento original. A diferença é que algumas palavras ou linhas passam a responder à seleção e à pesquisa. O texto copiado pode ser razoavelmente correto ou apresentar falhas, dependendo da qualidade do reconhecimento.
Também é possível encontrar uma camada textual desalinhada. Nesse caso, o destaque pode aparecer um pouco acima, abaixo ou ao lado das letras visíveis. Embora a posição não esteja perfeita, a capacidade de localizar e copiar caracteres sugere que há texto associado à página.
PDF criado originalmente com texto digital
Nem todo PDF pesquisável passou por OCR. Um arquivo exportado de um editor de texto, de uma planilha ou de um sistema eletrônico já pode conter caracteres digitais desde a origem. A busca e a seleção funcionarão, mas não há necessariamente uma imagem escaneada nem uma camada criada por reconhecimento óptico.
O navegador consegue indicar que existem caracteres pesquisáveis, mas geralmente não consegue informar com segurança se eles foram digitados originalmente ou gerados por OCR. Para o objetivo prático de pesquisar e copiar, essa distinção pode ser menos importante. Ela se torna relevante quando é preciso avaliar a qualidade do reconhecimento ou preservar a estrutura visual do documento.
Sinais que confirmam a presença de uma camada de texto
Nenhum indício isolado garante que todas as páginas tenham sido reconhecidas. Ainda assim, alguns sinais combinados oferecem uma avaliação consistente sobre a existência de texto associado à imagem.
A seleção acompanha palavras e linhas
Quando o destaque segue caracteres individuais, palavras ou linhas, o PDF provavelmente contém texto interpretável naquela região. A seleção pode não coincidir perfeitamente com as letras visíveis, principalmente quando a página está inclinada ou a imagem apresenta margens irregulares.
Se a seleção atravessa áreas vazias, inclui uma palavra próxima ou marca uma caixa maior do que o texto, isso pode resultar do posicionamento impreciso da camada OCR. O comportamento ainda é diferente de uma página totalmente sem texto, na qual nada pode ser selecionado como caractere.
A busca encontra palavras visíveis
A pesquisa é um dos testes mais úteis porque verifica se o visualizador consegue localizar uma sequência de caracteres. Procure uma palavra visível em uma página específica e observe onde o destaque aparece. Depois, repita o procedimento com termos de outras páginas.
Uma busca bem-sucedida em várias partes do documento sugere uma cobertura ampla, mas não prova que todas as linhas foram reconhecidas. Se o arquivo tiver muitas páginas, escolha amostras do início, do meio e do fim. Também vale testar folhas que tenham aparência diferente, pois elas podem ter sido incluídas de outra fonte.
O texto copiado corresponde à imagem
Mesmo com erros, o texto copiado deve guardar alguma relação com o conteúdo visível. Palavras incompletas, acentos ausentes e números confundidos com letras são falhas comuns em documentos de baixa qualidade. Se o resultado apresentar caracteres correspondentes ao trecho observado, há evidência de uma camada textual.
Por outro lado, uma cópia vazia, repetida em diferentes páginas, sugere que não há texto acessível naquela parte. A confirmação fica mais segura quando a ausência de conteúdo ocorre junto com a impossibilidade de selecionar palavras e com a falha da pesquisa interna.
O resultado varia entre páginas
Diferenças entre páginas são frequentes em arquivos montados a partir de fontes variadas. Uma capa pode conter texto digital, páginas internas podem ter OCR e um anexo pode ser somente uma imagem. Essa composição mista explica por que o teste funciona em uma folha e falha em outra.
Por isso, a conclusão deve ser específica. Em vez de afirmar que o documento inteiro tem ou não tem OCR, pode ser mais preciso dizer que determinadas páginas possuem texto pesquisável, enquanto outras não apresentaram sinais de reconhecimento.
Diferença entre PDF pesquisável, editável e preenchível
Os termos pesquisável, editável e preenchível descrevem características diferentes. Confundir essas funções pode levar a uma conclusão incorreta sobre o OCR do arquivo.
| Tipo de conteúdo | O que normalmente permite fazer | O que não comprova sozinho |
|---|---|---|
| Imagem sem texto | Visualizar e ampliar a página | Não oferece evidência de texto pesquisável |
| Texto digital ou camada OCR | Pesquisar, selecionar e copiar caracteres | Não garante que o conteúdo seja totalmente editável |
| Campo de formulário | Digitar ou alterar informações em áreas específicas | Não comprova que as palavras impressas na página tenham OCR |
| PDF editável em um programa compatível | Modificar alguns objetos, textos ou elementos | Não garante que todas as páginas tenham a mesma estrutura |
Texto pesquisável não é necessariamente texto editável
Um PDF pode permitir a pesquisa e a cópia de uma frase sem oferecer uma forma simples de alterar as letras visíveis. Isso acontece com frequência em documentos escaneados que receberam uma camada OCR. O texto reconhecido existe para leitura e localização, enquanto a aparência principal continua vinculada à imagem.
Em um arquivo criado originalmente em um editor, o texto pode ser mais consistente e, em alguns programas, ser convertido ou editado com maior facilidade. Mesmo assim, a possibilidade de editar depende do programa usado, das permissões do arquivo e da forma como os elementos foram incorporados.
Campos preenchíveis não são prova de OCR
Um formulário pode ter caixas de preenchimento sobre uma página escaneada. O usuário consegue clicar em um campo e digitar, mas as instruções impressas ao redor podem continuar sendo apenas parte da imagem.
Para verificar o OCR, teste as palavras que já estavam na página antes do preenchimento. Não use somente o conteúdo digitado em uma caixa como evidência, pois campos interativos são objetos independentes e podem existir mesmo quando não há texto reconhecido no restante do documento.
Como avaliar a qualidade do OCR encontrado
Identificar uma camada textual é apenas a primeira etapa. Um PDF pode ser pesquisável e, ainda assim, apresentar erros suficientes para dificultar a reutilização do conteúdo. A qualidade deve ser observada especialmente quando o texto será copiado para outro documento.
Teste palavras com acentos
Escolha termos que contenham acentos e compare a busca com a imagem. O reconhecimento pode preservar corretamente a grafia, remover sinais ou interpretar uma letra de forma diferente. Pesquisar a mesma palavra com e sem acento pode ajudar a identificar como a camada foi construída.
Teste datas e números
Números pequenos ou pouco nítidos podem ser confundidos com letras semelhantes. Faça uma cópia de datas, códigos e valores que estejam claramente visíveis e confira o resultado caractere por caractere. Uma falha em um número pode alterar o significado do conteúdo, portanto não trate o texto reconhecido como uma transcrição automaticamente perfeita.
Observe tabelas e colunas
O OCR pode reconhecer as palavras de uma tabela, mas não manter a disposição das colunas ao copiar. O resultado pode aparecer em uma sequência diferente da visualização original. Em páginas com duas colunas, cabeçalhos ou notas laterais, a ordem de leitura também pode ficar desorganizada.
Esse comportamento não significa necessariamente que a camada esteja ausente. Ele mostra que a posição dos elementos não foi interpretada de modo ideal. Se a estrutura da tabela for importante, compare a imagem com o texto copiado e considere revisar manualmente o resultado.
Teste rápido em três etapas
Para uma verificação inicial, use este procedimento:
- Selecione uma frase em uma página com texto corrido.
- Pesquise uma palavra que esteja dentro dessa mesma frase.
- Copie o trecho e cole-o em um editor de texto.
Se a frase puder ser selecionada, a palavra for localizada e o conteúdo aparecer na cópia, há uma indicação consistente de texto associado à página. Se nenhum dos três testes funcionar, a página pode ser formada apenas por uma imagem.
Quando os resultados forem diferentes, classifique o arquivo com cautela. Uma busca que funciona, mas não permite seleção, pode indicar uma camada textual com comportamento específico do visualizador. Um campo que aceita digitação não deve ser confundido com o texto original. Já uma seleção que funciona somente na capa sugere que o documento precisa ser testado em outras páginas.
O que fazer depois da verificação
Se o PDF já tiver uma camada textual e o conteúdo estiver legível, talvez não seja necessário aplicar OCR novamente. Uma nova conversão pode criar caracteres duplicados, sobreposição de camadas ou resultados mais difíceis de copiar. Antes de repetir o processo, confirme se o problema está realmente na ausência de texto ou apenas na qualidade da camada existente.
Se algumas páginas não permitirem pesquisa, o arquivo pode ter OCR parcial. Nesse caso, a avaliação deve considerar quais páginas precisam de reconhecimento e qual é o objetivo do trabalho. Para uma busca ocasional, a camada existente pode ser suficiente. Para reutilizar o texto em outro documento, será necessário conferir a precisão das áreas mais importantes.
Se nenhuma página permitir seleção, pesquisa ou cópia de palavras visíveis, o PDF provavelmente contém imagens sem texto associado. A partir dessa constatação, pode ser considerado um processo de reconhecimento, sempre com revisão posterior para verificar acentos, números, tabelas e organização das linhas.
Perguntas frequentes sobre como saber se um PDF tem OCR
É possível verificar OCR sem instalar programas?
Sim. O navegador pode ser usado para testar seleção, pesquisa e cópia em muitos arquivos. Esses procedimentos não substituem uma análise técnica completa, mas normalmente são suficientes para descobrir se existe texto interpretável em uma página.
Não conseguir selecionar texto prova que o PDF não tem OCR?
Não necessariamente. Pode haver limitações do visualizador, páginas com estruturas incomuns ou reconhecimento aplicado somente a determinados trechos. A conclusão fica mais segura quando a busca também não encontra palavras visíveis e a cópia não produz caracteres em várias páginas.
Um PDF pesquisável sempre passou por OCR?
Não. Ele pode ter sido criado originalmente a partir de texto digital. A pesquisa confirma a existência de caracteres que o visualizador consegue interpretar, mas não identifica sozinha a origem desses caracteres.
Por que o texto copiado aparece fora de ordem?
A camada OCR relaciona caracteres a posições na página, mas pode ter dificuldade para interpretar colunas, tabelas, carimbos, cabeçalhos e áreas próximas. O texto copiado pode seguir uma ordem diferente da leitura visual, mesmo quando as palavras foram reconhecidas.
O OCR reconhece todas as páginas automaticamente?
Não é possível presumir que todas as páginas receberam o mesmo tratamento. Um PDF pode conter folhas digitais, páginas escaneadas com OCR e anexos sem qualquer camada textual. Teste amostras do início, do meio e do fim para obter uma visão mais representativa.
Uma camada OCR garante que o texto esteja correto?
Não. Ela indica que caracteres foram associados à imagem, mas erros de reconhecimento podem ocorrer. Confira especialmente nomes, datas, números, códigos, valores e palavras com acentos antes de usar o conteúdo em outro contexto.
Conclusão
Como saber se um PDF tem OCR envolve observar mais do que a aparência da página. O caminho mais prático é combinar três verificações: selecionar palavras, pesquisar termos visíveis e copiar trechos para um editor. Quando esses recursos funcionam em diferentes páginas, há uma indicação consistente de que o arquivo contém texto pesquisável, seja por OCR ou por ter sido criado originalmente com caracteres digitais.
Também é importante separar um PDF pesquisável de um PDF editável ou preenchível. Uma caixa de formulário pode aceitar digitação sem que o texto impresso ao redor seja reconhecido, enquanto uma camada OCR pode permitir pesquisa e cópia sem tornar a página totalmente editável. Ao testar páginas variadas e conferir a qualidade do conteúdo copiado, você consegue distinguir entre um arquivo sem texto, um documento com OCR parcial e um PDF pesquisável que já atende ao objetivo.