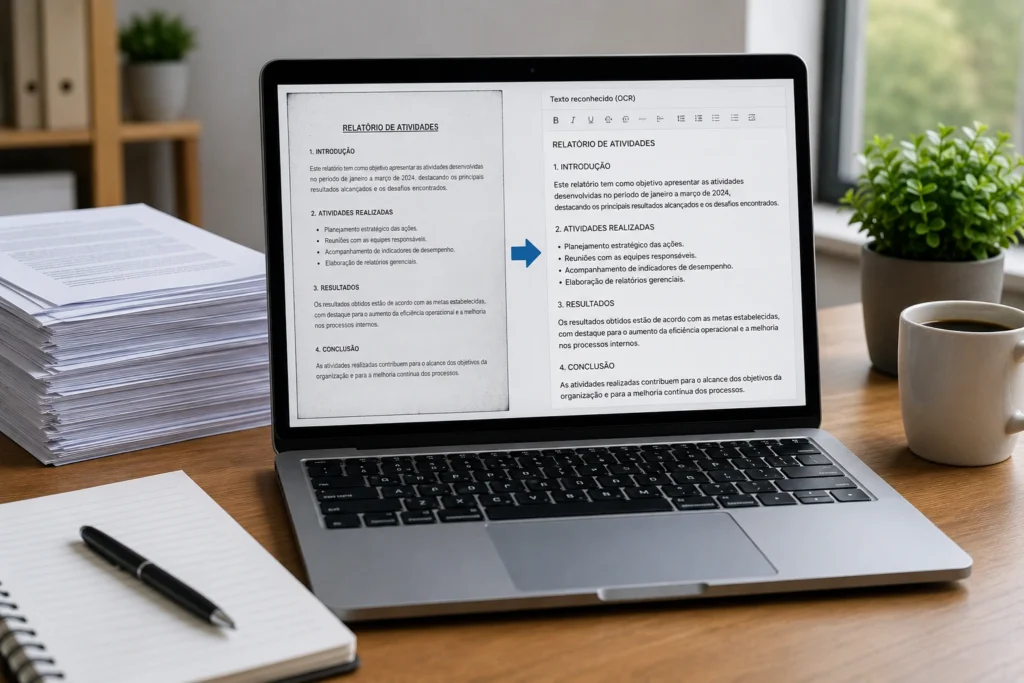
Por que o OCR reconhece um documento e falha em outro? A resposta está na combinação entre qualidade da imagem, tipografia, organização da página, idioma e tipo de conteúdo. O reconhecimento óptico de caracteres, conhecido pela sigla OCR, não interpreta uma folha exatamente como uma pessoa. Ele analisa padrões visuais e tenta convertê-los em letras, números, símbolos, palavras e blocos de informação. Por isso, dois documentos com frases semelhantes podem produzir resultados muito diferentes quando pequenas variações alteram a aparência ou a estrutura da página.
Um arquivo pode parecer perfeitamente legível na tela e ainda conter sinais insuficientes para o OCR. Uma letra apagada, uma sombra, uma linha torta ou uma tabela com colunas estreitas já pode mudar a forma como o sistema separa e interpreta os elementos. Entender essas limitações ajuda a identificar a origem dos erros e a revisar o texto extraído com mais eficiência.
Por que o OCR reconhece um documento e falha em outro?
O OCR precisa realizar várias etapas para transformar uma imagem em texto. Primeiro, localiza áreas que provavelmente contêm informação. Depois, tenta separar linhas, palavras e caracteres. Em seguida, compara os padrões visuais encontrados com formas conhecidas e produz uma sequência textual. Em documentos mais avançados, também pode usar informações linguísticas e contextuais para escolher entre interpretações semelhantes.
Esse processo não significa que o sistema compreenda o documento da mesma maneira que uma pessoa. Ele identifica sinais visuais e calcula quais interpretações parecem mais compatíveis. Se a imagem não mostrar claramente a diferença entre dois caracteres, o OCR pode escolher uma alternativa plausível, mas incorreta.
Uma letra com uma pequena mancha pode ser interpretada como parte do caractere, como pontuação ou como ruído. Da mesma forma, uma palavra pode ser reconhecida individualmente, mas aparecer na posição errada porque o sistema não identificou corretamente a estrutura da página.
O reconhecimento depende de várias decisões visuais
Para reconhecer uma linha, o OCR precisa determinar onde ela começa e termina, quais marcas pertencem aos caracteres e qual é a ordem das palavras. Uma falha em qualquer uma dessas etapas pode afetar o resultado final.
Em uma página nítida e bem alinhada, as letras tendem a formar padrões consistentes. Já em uma imagem inclinada, desfocada ou com fundo irregular, o sistema precisa separar o texto de sinais que não pertencem a ele. Uma sombra pode parecer uma faixa de texto; uma borda pode ser confundida com um traço; e um ponto apagado pode fazer uma letra se parecer com outra.
O erro também pode ser localizado. Uma página inteira pode ser convertida corretamente, enquanto uma linha específica apresenta substituições ou omissões. Isso ocorre quando aquela região tem impressão mais fraca, foi parcialmente coberta ou apresenta caracteres diferentes dos demais.
A legibilidade humana não é igual à legibilidade para o OCR
As pessoas conseguem usar contexto, conhecimento de vocabulário e expectativa para completar formas incompletas. Ao ler uma frase, é possível deduzir uma palavra mesmo quando uma letra está parcialmente apagada. O OCR, por sua vez, depende principalmente dos sinais registrados na imagem e dos modelos utilizados pelo sistema.
Essa diferença explica por que uma pessoa pode entender um texto que o OCR converte com erros. A leitura humana tende a compensar pequenas falhas visuais, enquanto o reconhecimento automático precisa decidir qual forma corresponde a cada caractere. Quando duas interpretações são visualmente parecidas, o sistema pode escolher a opção inadequada.
Como a qualidade da imagem interfere no reconhecimento
A imagem é a matéria-prima do OCR. Quanto mais detalhes forem preservados, maior será a possibilidade de distinguir caracteres, acentos, pontuação e limites entre palavras. Quando a imagem perde informação, o sistema recebe sinais ambíguos e pode gerar um texto incompleto ou desorganizado.
Resolução baixa e caracteres pequenos
Em uma digitalização de baixa resolução, letras pequenas ocupam poucos pixels. Isso reduz a quantidade de detalhes disponível para identificar curvas, hastes, pontos e espaços internos. Um “o” pode parecer fechado ou irregular, enquanto um “a” pode perder a característica que o diferencia de outras letras.
O problema é mais comum em recibos, formulários, etiquetas, notas de rodapé e documentos que foram ampliados a partir de uma cópia pequena. A página pode parecer aceitável quando visualizada inteira, mas os caracteres não têm informação suficiente para uma conversão confiável.
Caracteres estreitos também são vulneráveis. Um “l” pode ser confundido com “I”, “i” ou uma marca vertical. Em determinadas fontes, a diferença entre esses sinais depende de detalhes mínimos, como um ponto, uma base ou uma pequena variação de espessura.
Desfoque e movimento
O desfoque reduz a nitidez dos contornos. Quando a página é fotografada com movimento da câmera ou fora de foco, traços finos podem desaparecer e caracteres vizinhos podem parecer unidos. Combinações como “cl”, “rn” e “m” podem ficar visualmente próximas quando as bordas deixam de estar definidas.
O desfoque também pode fazer com que uma linha tenha diferentes níveis de clareza. Uma parte da página pode estar focada, enquanto outra apresenta perda de definição por causa da curvatura do papel ou da distância em relação à câmera. O resultado costuma conter erros concentrados em regiões específicas.
Compressão e artefatos digitais
A compressão pode reduzir o tamanho do arquivo, mas alguns métodos introduzem blocos, manchas e contornos artificiais. Esses sinais podem aparecer ao redor de letras escuras sobre fundo claro. Embora não pertençam ao documento original, passam a fazer parte da imagem analisada pelo OCR.
Um artefato pode ser interpretado como acento, ponto, hífen ou prolongamento de um caractere. Em textos pequenos, a alteração de poucos pixels pode modificar a forma percebida de uma letra. Por isso, uma imagem que parece nítida à distância pode apresentar dificuldades quando ampliada.
Contraste insuficiente
O OCR precisa separar o texto do fundo. Quando a tinta está desbotada e o papel tem tonalidade semelhante, os limites dos caracteres ficam menos evidentes. Uma impressão cinza sobre uma folha amarelada, por exemplo, pode gerar formas incompletas ou interrompidas.
O contraste reduzido também ocorre em cópias antigas, documentos escaneados com configurações inadequadas e fotografias feitas sob iluminação irregular. Nesses casos, algumas letras podem desaparecer parcialmente, enquanto outras permanecem visíveis.
Sombras, reflexos e fundo irregular
Sombras sobre a página criam áreas escuras que competem com o texto. Uma faixa projetada sobre várias linhas pode ser interpretada como parte dos caracteres ou como um elemento independente. Reflexos também podem apagar trechos de uma palavra, especialmente quando a folha é fotografada sob luz direta.
O fundo pode apresentar textura, manchas, dobras ou variações de cor. Esses elementos dificultam a separação entre informação e ruído. Uma marca no papel pode ser confundida com pontuação, enquanto uma borda escurecida pode ser identificada como um bloco de conteúdo.
Carimbos e marcas coloridas não são necessariamente ignorados pelo OCR. Dependendo do contraste da imagem, seus traços podem atravessar letras, engrossar contornos ou acrescentar formas entre as palavras. O sistema analisa a imagem recebida, e não a intenção de quem produziu cada marca.
Inclinação e perspectiva
Linhas horizontais facilitam a localização das palavras. Quando a página é fotografada torta, as linhas ficam inclinadas e podem ser separadas de maneira inadequada. Uma inclinação moderada talvez não impeça o reconhecimento de cada letra, mas pode afetar o espaçamento, a ordem e as quebras de linha.
A perspectiva causa uma distorção adicional. Se a câmera não estiver alinhada com a superfície do papel, um lado da página pode parecer maior que o outro. Os caracteres assumem proporções diferentes conforme a distância em relação à lente, dificultando a identificação de linhas e colunas.
Curvatura de páginas encadernadas
Livros, cadernos e documentos encadernados podem ficar curvados perto da lombada. Nessa região, as palavras parecem comprimidas ou inclinadas, enquanto as extremidades permanecem mais planas. A deformação altera a distância entre os caracteres e pode dificultar a leitura de linhas inteiras.
Quando a curvatura é intensa, o OCR pode tratar uma mesma linha como partes diferentes ou associar palavras à linha seguinte. Mesmo que os caracteres estejam parcialmente legíveis, a estrutura geométrica da página deixa de ser uniforme.
O impacto da tipografia e dos elementos gráficos
A qualidade da imagem não é o único fator relevante. A própria aparência dos caracteres e a disposição dos elementos influenciam o reconhecimento. Fontes pouco comuns, texto manuscrito, tabelas e anotações sobrepostas oferecem padrões mais difíceis de separar e interpretar.
Fontes pequenas, decorativas e incomuns
Fontes pequenas apresentam menos detalhes para análise. Traços finos podem desaparecer, espaços internos podem ser fechados e pontos podem se misturar às letras. Em uma palavra curta, a perda de apenas um detalhe pode alterar completamente o resultado.
Fontes decorativas acrescentam curvas, ornamentos e variações que não aparecem em tipografias mais simples. Um “r” estilizado pode se aproximar visualmente de um “v”, enquanto um “s” pode lembrar o número “5”. O OCR não interpreta o propósito estético da fonte; ele compara as formas visíveis com padrões disponíveis.
Texto manuscrito
A escrita manual tende a variar entre pessoas e até dentro da mesma página. Uma pessoa pode escrever o número “1” com ou sem base, modificar a forma do “a” ou unir várias letras em uma única sequência. Essas variações dificultam a segmentação e a identificação individual dos caracteres.
Assinaturas e rubricas são ainda mais complexas porque usam linhas contínuas, curvas e movimentos que não seguem necessariamente a estrutura de uma palavra. Um traço pode atravessar várias letras e ser interpretado como parte do texto, como pontuação ou como uma linha independente.
Tabelas e colunas
Em um parágrafo, a posição das palavras costuma indicar uma ordem de leitura relativamente simples. Tabelas e colunas quebram essa regularidade. O OCR precisa descobrir quais palavras pertencem à mesma linha, qual conteúdo corresponde a cada coluna e em que sequência os blocos devem ser apresentados.
Considere uma tabela com as colunas “Produto”, “Quantidade” e “Valor”. O sistema pode reconhecer todos os produtos primeiro, depois as quantidades e, por fim, os valores. Nesse caso, os caracteres podem estar corretos, mas a relação entre cada item e seu respectivo valor fica comprometida.
Em duas colunas de texto, também é possível que a extração alterne entre a coluna da esquerda e a da direita. A ordem visual da página nem sempre coincide com a ordem produzida pelo arquivo de saída. Por isso, a revisão de documentos estruturados deve verificar não apenas as palavras, mas também a posição relativa dos blocos.
Caixas, bordas e formulários
Linhas e bordas podem ser interpretadas como caracteres. Uma linha horizontal pode parecer um hífen ou sublinhado, enquanto uma borda vertical pode ser confundida com uma letra estreita. Quando estão muito próximas do texto, essas marcas dificultam a separação dos campos.
Em um formulário com os rótulos “Data” e “Local”, por exemplo, o OCR pode misturar o conteúdo das duas áreas se os limites não estiverem claros. O problema pode não estar no reconhecimento das palavras, mas na relação entre cada rótulo e o valor preenchido.
Carimbos, anotações e sobreposições
Um carimbo sobre uma palavra altera os contornos originais e acrescenta novas formas à mesma região. Seus traços podem cobrir parte de letras, atravessar números ou criar marcas semelhantes a pontuação. O texto ao redor pode ser reconhecido corretamente, enquanto os caracteres diretamente atingidos apresentam falhas.
Anotações manuscritas nas margens também podem ser associadas à linha mais próxima. Setas, círculos e marcações podem ser interpretados como símbolos ou como parte de uma palavra. Quando uma anotação atravessa o texto, ela pode dividir uma sequência, unir caracteres ou modificar a ordem dos blocos.
| Característica do documento | Possível efeito no OCR | Aspecto que merece revisão |
|---|---|---|
| Imagem desfocada ou pequena | Troca, omissão ou união de caracteres | Letras estreitas, acentos e pontuação |
| Contraste baixo ou fundo irregular | Desaparecimento parcial de traços | Linhas apagadas e áreas sombreadas |
| Tabela ou formulário | Ordem alterada e campos misturados | Relação entre rótulos, linhas e valores |
| Texto manuscrito ou decorativo | Interpretação inconsistente das formas | Nomes, datas e caracteres semelhantes |
| Códigos alfanuméricos | Confusão entre letras, números e símbolos | Cada posição da sequência |
| Mais de um idioma | Alteração de acentos e combinações de letras | Palavras estrangeiras e nomes próprios |
Como o conteúdo do documento aumenta a dificuldade
Mesmo quando a imagem está razoavelmente nítida, o conteúdo pode criar ambiguidades. Códigos curtos, abreviações, números, acentos e idiomas diferentes oferecem menos contexto para confirmar a interpretação de cada caractere.
Letras e números visualmente parecidos
Alguns caracteres têm formas muito semelhantes, sobretudo em fontes pequenas ou desgastadas. O OCR pode confundir “0” com “O”, “1” com “I” ou “l”, “5” com “S” e “8” com “B”. Em uma sequência curta, uma única troca já altera o resultado inteiro.
Palavras comuns oferecem mais contexto para a escolha. Se uma letra estiver parcialmente apagada no meio de uma frase, a estrutura da palavra pode favorecer uma interpretação. Códigos, números de referência e identificadores normalmente não têm esse apoio. Várias combinações podem parecer igualmente plausíveis do ponto de vista visual.
Símbolos como hífen, barra, ponto e vírgula também exigem atenção. Eles podem separar campos, indicar uma data, fazer parte de um código ou representar pontuação. Um sinal pequeno ou pouco nítido pode ser omitido, substituído ou incorporado ao caractere vizinho.
Idiomas e acentos
A configuração de idioma orienta os padrões que o OCR considera mais prováveis. Ela pode ajudar na interpretação de acentos, combinações de letras e palavras frequentes, mas não corrige uma informação que não está visível na imagem.
Em português, acentos e sinais como til e cedilha podem desaparecer quando a impressão está fraca ou a resolução é baixa. Uma palavra pode ser reconhecida sem o acento, com uma marca deslocada ou com um caractere diferente. O restante da palavra pode estar correto, mas a alteração reduz a fidelidade do texto.
Documentos multilíngues apresentam outra dificuldade. Um formulário que combina português e inglês, por exemplo, reúne padrões vocabulares diferentes na mesma página. Se o processamento considerar apenas um idioma, termos estrangeiros podem ser divididos ou modificados.
Nomes próprios, endereços e expressões estrangeiras também podem ser reconhecidos de modo irregular. Como essas palavras não seguem necessariamente as combinações mais comuns do idioma principal, o sistema dispõe de menos contexto para confirmar a leitura.
Documentos antigos e cópias sucessivas
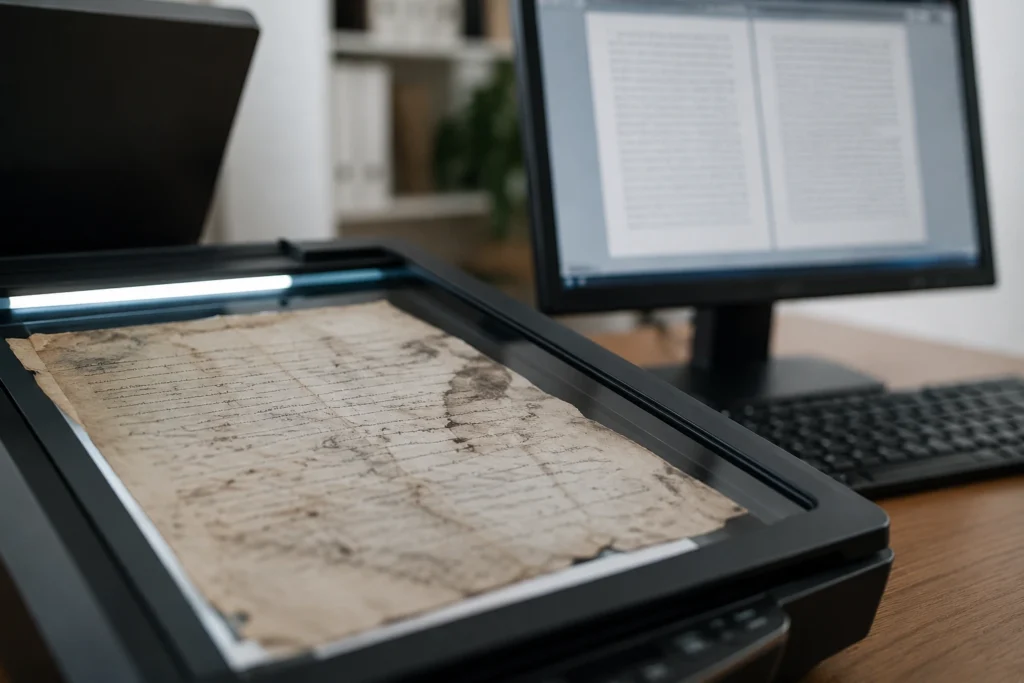
Documentos antigos podem apresentar desgaste, impressão irregular e falhas repetidas em determinados caracteres. Em páginas datilografadas, algumas letras podem ser pressionadas com mais força, enquanto outras aparecem incompletas. Em cópias sucessivas, manchas e perda de detalhes tendem a se acumular.
Uma reprodução pode deixar certas letras mais pesadas, apagar traços finos ou transformar marcas do papel em parte da impressão. O OCR pode acertar uma ocorrência de determinada letra e errar outra, mesmo quando ambas deveriam ser iguais.
Recibos e documentos com impressão térmica também podem perder contraste com o tempo. Números, símbolos monetários e separadores decimais são especialmente importantes para revisão porque uma pequena alteração pode mudar o sentido da informação extraída.
PDF com texto selecionável e PDF digitalizado
Nem todo PDF precisa de OCR. Alguns arquivos já contêm uma camada de texto digital, que pode ser selecionada e copiada diretamente. Nesses casos, a aplicação não precisa interpretar visualmente cada letra para recuperar o conteúdo textual.
Um PDF digitalizado, por outro lado, costuma armazenar cada página como uma imagem. Para torná-la pesquisável ou copiável, o OCR precisa identificar os caracteres presentes na imagem. Se a digitalização estiver desfocada, inclinada ou incompleta, o texto extraído ficará sujeito a esses problemas.
Um mesmo arquivo pode combinar páginas de tipos diferentes. Algumas podem conter texto nativo, enquanto outras são imagens. Por isso, é possível que uma parte do documento seja copiada com precisão e outra apresente substituições, omissões ou ordem incorreta.
Uma forma simples de observar essa diferença é tentar selecionar uma palavra com o cursor. Se não for possível selecionar caracteres individualmente, a página provavelmente depende de reconhecimento visual para gerar uma camada de texto. Essa verificação não substitui a revisão, mas ajuda a explicar por que páginas do mesmo arquivo apresentam comportamentos distintos.
Como reduzir erros de OCR sem refazer a digitalização
Nem sempre é necessário produzir uma nova imagem. Quando a informação ainda está presente, ajustes na preparação e no processamento podem facilitar o reconhecimento. Essas medidas não recuperam detalhes completamente apagados, mas podem melhorar a separação entre texto e fundo.
Preparar a imagem
- Corrigir a orientação da página antes do reconhecimento.
- Recortar áreas que não fazem parte do documento.
- Reduzir sombras, reflexos e variações intensas de fundo quando isso for possível.
- Melhorar o contraste sem eliminar acentos ou traços finos.
- Evitar compressão excessiva e múltiplas conversões do mesmo arquivo.
- Separar páginas ou regiões muito diferentes quando o processo permitir.
O tratamento deve preservar os detalhes do texto. Um ajuste muito intenso pode engrossar letras, apagar pontos ou transformar uma borda em parte do caractere. O objetivo é tornar os sinais mais consistentes, não alterar a aparência original de forma agressiva.
Escolher o idioma adequado
A configuração de idioma deve corresponder ao conteúdo principal. Isso pode ajudar na interpretação de acentos e combinações comuns de letras. Quando a página contém mais de um idioma, é importante verificar se o recurso utilizado permite uma configuração compatível com essa mistura.
Alterar o idioma não resolve problemas causados por desfoque, manchas ou caracteres ausentes. Se o acento não estiver visível, por exemplo, nenhuma configuração poderá garantir sua recuperação. O idioma é um apoio para a interpretação, não uma substituição da qualidade da imagem.
Tratar tabelas e regiões diferentes separadamente
Um documento que reúne texto corrido, tabela, formulário e anotações pode exigir abordagens diferentes para cada área. Quando o processo permitir, separar esses blocos reduz a chance de que a estrutura de uma região seja aplicada incorretamente a outra.
Em tabelas, o resultado deve ser conferido por linha e coluna. Em formulários, é importante verificar se cada valor permaneceu associado ao rótulo correto. Em texto corrido, a atenção pode se concentrar em palavras incomuns, pontuação e quebras de linha.
Revisar as áreas de maior risco
A revisão não precisa tratar todos os caracteres com a mesma intensidade. Os pontos mais importantes costumam ser nomes próprios, datas, números, códigos, valores, endereços e termos com acentos. Esses elementos podem parecer corretos mesmo quando contêm uma única substituição relevante.
Comparar o texto extraído com a imagem original é a forma mais segura de identificar divergências. Uma leitura rápida pode não perceber a troca entre “O” e “0”, a ausência de um hífen ou a inversão de duas colunas. A conferência deve considerar tanto os caracteres quanto a estrutura do documento.
Como identificar a provável causa do erro
O padrão dos erros oferece pistas sobre sua origem. Quando os problemas aparecem apenas em áreas escuras, dobradas ou desfocadas, a qualidade da imagem provavelmente tem papel importante. Quando as alterações ocorrem de maneira uniforme em palavras de um idioma específico, a configuração linguística pode estar contribuindo.
Erros de ordem, campos misturados e colunas deslocadas apontam para dificuldades de estrutura da página. Já trocas entre letras e números costumam exigir atenção especial à tipografia, ao desgaste da impressão e ao tipo de conteúdo.
| Padrão observado | Causa provável | Conferência recomendada |
|---|---|---|
| Erros concentrados em uma faixa escura | Sombra, baixo contraste ou marca sobreposta | Comparar a área afetada com a imagem original |
| Caracteres unidos ou incompletos | Desfoque, baixa resolução ou compressão | Verificar contornos e espaçamento entre letras |
| Palavras fora de ordem | Colunas, tabela ou formulário mal segmentado | Revisar a posição de cada bloco na página |
| Trocas entre “O” e “0” | Fonte pequena, desgaste ou código alfanumérico | Conferir cada posição da sequência |
| Acentos ausentes | Imagem insuficiente ou idioma inadequado | Testar configuração compatível e comparar com o original |
| Problemas apenas em páginas fotografadas | Perspectiva, inclinação ou iluminação | Verificar geometria e uniformidade da captura |
Perguntas frequentes sobre erros de OCR
Por que o OCR erra mais em documentos digitalizados?
Porque o sistema precisa interpretar visualmente cada caractere. Em um arquivo que já contém texto digital, as letras podem ser recuperadas diretamente. Em uma digitalização, o conteúdo está representado por pixels, e qualquer falha de imagem pode alterar a interpretação.
Uma página pode parecer legível para uma pessoa e ainda não apresentar detalhes suficientes para distinguir caracteres parecidos. Por isso, a qualidade do arquivo visual tem influência direta no resultado.
É possível melhorar o resultado sem digitalizar novamente?
Em muitos casos, sim. Corrigir a orientação, ajustar o contraste, recortar áreas desnecessárias, escolher o idioma adequado e separar regiões complexas pode ajudar. Essas medidas funcionam melhor quando os detalhes essenciais ainda estão presentes na imagem.
Se uma letra foi completamente apagada ou coberta, o processamento não poderá recuperar com segurança a informação original. Nessas situações, a comparação com outra cópia ou com a fonte original pode ser necessária.
Por que tabelas e colunas saem desorganizadas?
Porque o OCR precisa reconstruir uma ordem de leitura a partir da posição dos elementos. Em uma tabela, vários conteúdos ocupam a mesma altura; em duas colunas, blocos diferentes ficam lado a lado. O sistema pode reconhecer os caracteres, mas associá-los a linhas ou colunas incorretas.
A revisão deve verificar se cada valor continua ligado ao rótulo e à linha correspondentes. Em documentos estruturados, essa relação pode ser tão importante quanto a grafia de cada palavra.
Como diferenciar um problema de imagem de um problema de idioma?
Observe a distribuição dos erros. Problemas de imagem tendem a acompanhar regiões desfocadas, sombreadas, dobradas ou apagadas. Problemas de idioma podem afetar palavras de forma mais regular, especialmente acentos, combinações incomuns e termos estrangeiros.
Um teste útil é processar um trecho nítido com configurações de idioma diferentes, mantendo a mesma imagem. Se os resultados mudarem bastante, o idioma pode estar contribuindo. Se os mesmos caracteres continuarem ilegíveis, a limitação provavelmente está na imagem.
Por que documentos antigos confundem letras e números?
O desgaste pode apagar justamente os traços que diferenciam caracteres semelhantes. “O” e “0”, “I” e “1” ou “S” e “5” podem ficar muito próximos visualmente quando a impressão está incompleta.
Em palavras, o contexto pode ajudar a confirmar uma leitura. Em códigos curtos, datas e sequências alfanuméricas, há menos informação para orientar a escolha. Por isso, esses trechos exigem conferência posição por posição.
A precisão do OCR começa antes do reconhecimento
A qualidade do OCR não depende apenas do mecanismo que converte imagens em texto. Ela começa nas condições do documento recebido: resolução, foco, contraste, iluminação, alinhamento, tipografia, idioma e estrutura da página.
O resultado também pode variar dentro do mesmo arquivo. Um parágrafo nítido e bem alinhado oferece sinais consistentes, enquanto uma tabela com bordas, um campo manuscrito ou uma linha coberta por uma marca apresenta muito mais ambiguidade.
Por isso, a revisão deve acompanhar o tipo de risco. Em texto corrido, vale observar palavras incomuns e acentos. Em tabelas, a prioridade é preservar as relações entre linhas e colunas. Em códigos e números, cada caractere deve ser conferido. Em documentos antigos, as áreas de impressão fraca merecem atenção adicional.
Entender por que o OCR reconhece um documento e falha em outro torna a análise mais objetiva. Em vez de tratar o erro como aleatório, é possível relacioná-lo às características visuais e estruturais da página. Com uma preparação adequada e uma revisão direcionada, a extração tende a ficar mais consistente, sem perder de vista que o texto gerado deve ser comparado ao documento original sempre que a precisão for importante.