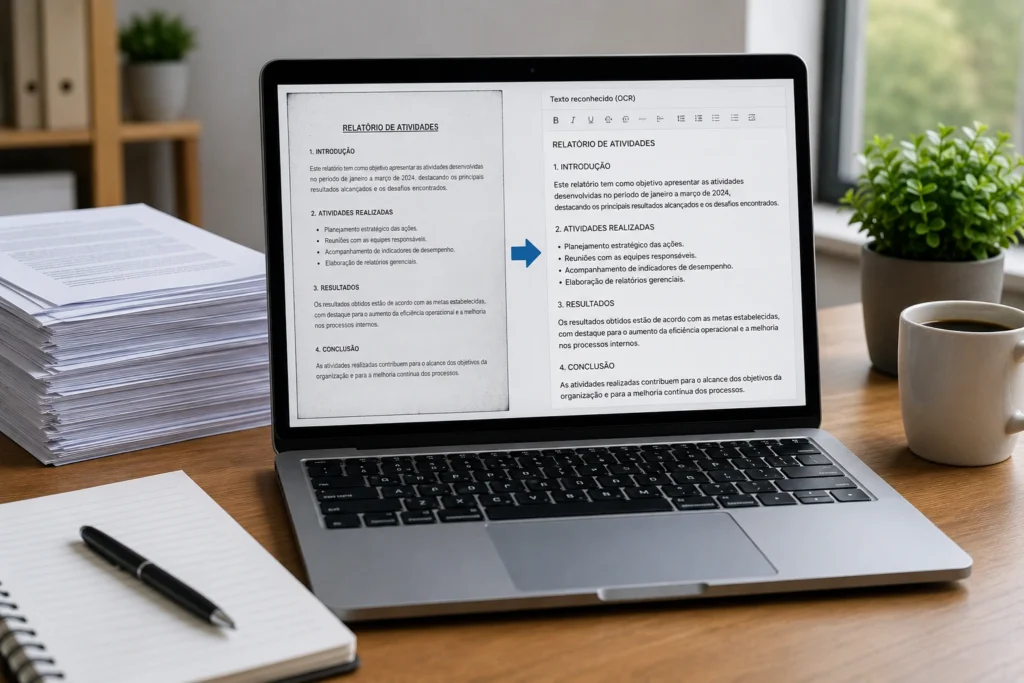
O OCR transforma uma imagem em texto ao interpretar padrões visuais presentes nos pixels. Em vez de encontrar caracteres já armazenados no arquivo, ele analisa formas, contrastes, posições e relações entre os elementos da página para estimar quais letras, números e símbolos estão representados. É por isso que uma fotografia de um documento pode se tornar um conteúdo selecionável, pesquisável e, em muitos casos, editável.
Esse processo envolve várias etapas. Primeiro, a imagem é preparada para reduzir interferências, como inclinação, sombras, ruídos e iluminação irregular. Depois, o sistema identifica possíveis áreas de texto, separa blocos, linhas e palavras e compara as formas encontradas com padrões de caracteres. Por fim, utiliza o contexto linguístico e a estrutura da página para montar uma sequência textual coerente.
Entender como o OCR funciona ajuda a interpretar seus resultados com mais segurança. A tecnologia é útil para digitalizar documentos, localizar informações em arquivos escaneados e facilitar a acessibilidade, mas não deve ser tratada como uma transcrição automaticamente perfeita. A qualidade da imagem, o tipo de documento e a organização visual influenciam diretamente a precisão da conversão.
Como o OCR transforma uma imagem em texto
Uma imagem contém uma representação visual formada por pixels. Cada pixel registra informações como luminosidade e cor, mas não informa diretamente que determinada região representa a letra “A”, o número “8” ou uma palavra completa. Para converter essa representação em texto, o OCR precisa identificar padrões compatíveis com caracteres e reconstruir a sequência em que eles aparecem.
O sistema não observa a imagem exatamente como uma pessoa. Um leitor humano pode reconhecer rapidamente uma palavra mesmo quando uma parte está borrada, porque usa experiência, contexto e conhecimento do idioma. O OCR também pode utilizar contexto, mas precisa transformar sinais visuais em hipóteses calculadas. Ele avalia quais interpretações são mais compatíveis com a forma observada e com os elementos ao redor.
Em termos gerais, o fluxo pode ser dividido em quatro momentos:
- preparação da imagem para destacar os sinais relevantes;
- detecção da estrutura visual da página;
- reconhecimento de letras, números, símbolos e acentos;
- montagem do texto e indicação de possíveis incertezas.
Essas etapas podem ocorrer de maneira integrada. Sistemas modernos analisam regiões inteiras e sequências de caracteres, em vez de depender apenas da identificação isolada de cada letra. Ainda assim, o princípio permanece o mesmo: transformar evidências visuais em uma sequência textual provável.
A diferença entre uma imagem e um texto digital
Em um documento digital criado em um editor de texto, cada palavra é composta por caracteres. O computador consegue selecionar, copiar, pesquisar e modificar esse conteúdo porque reconhece letras, números, espaços e sinais de pontuação como elementos independentes.
Em uma página digitalizada, o arquivo registra a aparência do documento. O texto pode estar visível para uma pessoa, mas a imagem não informa diretamente que aquela forma corresponde aos caracteres “c”, “a”, “s” e “a”. Para o sistema, a página é uma composição de áreas claras, áreas escuras, contornos, espaços e cores.
Essa diferença explica por que não é possível copiar diretamente o texto de qualquer arquivo escaneado. O OCR atua como uma ponte entre os dois formatos: observa a imagem e cria uma camada textual que pode ser pesquisada, selecionada e utilizada por outros programas.
| Tipo de conteúdo | Como é armazenado | Possibilidade de seleção | Necessidade de OCR |
|---|---|---|---|
| Texto digital | Caracteres e elementos estruturados | Normalmente disponível | Geralmente não é necessária |
| Imagem escaneada | Pixels que representam a aparência da página | Não disponível por padrão | Normalmente necessária |
| Fotografia de documento | Pixels com possíveis distorções de iluminação e perspectiva | Não disponível por padrão | Necessária, com possível pré-processamento |
| PDF com camada de texto | Imagem acompanhada de caracteres reconhecidos | Disponível na camada textual | Pode ter sido usada na criação do arquivo |
Por que a imagem precisa ser preparada antes do OCR
O reconhecimento tende a ser mais consistente quando os caracteres estão nítidos e separados do fundo. Uma fotografia pode conter elementos que não fazem parte do documento, como uma mesa, sombras, reflexos ou bordas irregulares. Mesmo uma digitalização aparentemente simples pode apresentar manchas, falhas de impressão e variações de contraste.
A preparação da imagem não cria detalhes que desapareceram na captura. Ela apenas organiza e realça as informações disponíveis para que o sistema consiga analisá-las com menos interferência. Quando a letra foi totalmente apagada ou ocupa poucos pixels, nenhum ajuste garante uma recuperação correta.
Corte e identificação da área relevante
O primeiro ajuste pode consistir em localizar a página ou o bloco que contém o texto. O corte remove partes externas, como o fundo ao redor de uma folha, margens excessivas ou objetos que aparecem próximos ao documento. Isso reduz a quantidade de elementos que poderiam ser confundidos com escrita.
Em uma fotografia, o sistema pode tentar detectar as bordas da página e concentrar a análise dentro delas. Essa tarefa fica mais difícil quando o fundo tem cor semelhante ao papel, quando as bordas estão fora do enquadramento ou quando o documento possui formato irregular.
Correção da perspectiva e da inclinação
Um documento fotografado de frente tende a apresentar linhas horizontais e verticais próximas da posição original. Quando a câmera está inclinada, as linhas podem subir, descer ou convergir visualmente. A correção de perspectiva transforma a imagem para aproximá-la de uma visão frontal.
A inclinação menor, comum em digitalizações desalinhadas, pode ser corrigida por uma rotação. O sistema estima a direção predominante das linhas de texto e ajusta a página para que elas fiquem mais próximas da horizontal. Esse procedimento ajuda a separar linhas e a determinar a ordem de leitura.
Correções geométricas têm limites. Uma página dobrada, parcialmente coberta ou fotografada em ângulo muito acentuado pode apresentar deformações que não podem ser totalmente revertidas. Nesses casos, uma nova captura, feita com a câmera paralela ao documento e iluminação uniforme, costuma oferecer melhores condições.
Contraste, brilho e iluminação
O contraste representa a diferença visual entre os caracteres e o fundo. Letras escuras sobre papel claro normalmente oferecem uma separação favorável. Já um documento com impressão fraca ou fotografado em ambiente escuro pode apresentar caracteres próximos do tom do papel.
Além da iluminação geral, é importante considerar variações dentro da mesma página. Uma sombra pode escurecer apenas uma parte do documento, enquanto um reflexo pode clarear outra. O processamento pode compensar essas diferenças localmente, procurando tornar a escrita mais uniforme.
Ajustes excessivos podem causar o efeito contrário. Aumentar demais o contraste pode engrossar letras, fechar espaços internos ou fazer com que pontuação desapareça. Por isso, a preparação precisa preservar detalhes como acentos, pontos, vírgulas, hífens e traços finos.
Resolução e nitidez
A resolução determina quantos pixels representam cada caractere. Letras pequenas ou fontes muito finas podem perder detalhes quando a imagem é capturada em tamanho reduzido. Acentos, pontos e aberturas internas de letras são particularmente vulneráveis.
Ampliar uma imagem depois da captura não recupera automaticamente informações ausentes. O aumento apenas distribui ou interpola os pixels existentes. Uma imagem ampliada pode parecer maior, mas não necessariamente contém mais detalhes úteis para o OCR.
A nitidez também é importante. Desfoque causado por movimento, foco inadequado ou compressão intensa pode misturar os contornos de caracteres próximos. Em uma sequência como “11”, “ll” e “II”, pequenas perdas de definição podem dificultar a distinção entre letras e números.
Remoção de ruídos e manchas
Ruídos são pontos, granulações e marcas que não pertencem ao texto, mas aparecem na imagem. Eles podem surgir do sensor da câmera, da digitalização, da textura do papel ou da compressão do arquivo. O processamento pode atenuar esses elementos, desde que não remova partes legítimas dos caracteres.
Manchas maiores exigem cuidado adicional. Uma sombra que atravessa uma linha pode engrossar uma letra, enquanto uma marca d’água pode criar traços semelhantes aos da escrita. O sistema tenta distinguir padrões contínuos e amplos de marcas menores e organizadas, mas essa separação nem sempre é perfeita.
Filtros agressivos podem eliminar acentos, pontos e sinais de pontuação. Uma limpeza moderada costuma ser mais segura do que transformar a imagem em uma representação excessivamente simplificada. O objetivo é reduzir interferências sem destruir as evidências que o reconhecimento precisa analisar.
Como o OCR identifica linhas, palavras e caracteres
Depois da preparação, o OCR precisa compreender a organização visual do documento. Uma página não é apenas uma sequência contínua de formas: ela pode conter títulos, parágrafos, colunas, tabelas, legendas, formulários e áreas sem texto. A análise do layout ajuda a separar essas regiões antes do reconhecimento detalhado.
Análise do layout
O sistema observa a posição, o tamanho, o alinhamento e o espaçamento dos elementos. Linhas próximas e com altura semelhante podem pertencer ao mesmo bloco. Uma área vazia maior pode indicar a separação entre um título e o corpo do texto ou entre dois parágrafos.
Em uma página com duas colunas, o OCR precisa reconhecer que as linhas da coluna esquerda formam um grupo e as linhas da coluna direita formam outro. Sem essa divisão, a ordem final pode alternar trechos das duas colunas e produzir uma leitura diferente da organização original.
Elementos gráficos podem complicar essa análise. Uma linha horizontal pode ser uma borda de tabela, um separador, um sublinhado ou parte de um caractere. A posição e a relação do traço com os demais elementos ajudam o sistema a determinar seu papel.
Separação entre blocos, linhas e palavras
Dentro de cada região, o OCR procura identificar as linhas de texto. A distância vertical entre agrupamentos de traços ajuda a distinguir o fim de uma linha do espaço interno entre caracteres. Em seguida, os intervalos horizontais são usados para estimar onde uma palavra termina e outra começa.
Essa separação não é uma regra fixa. Letras estreitas, como “i”, ocupam menos espaço do que letras largas, como “m”. Um ponto pode aparecer acima do corpo de uma letra, e um hífen pode ser confundido com uma linha do formulário. O sistema precisa considerar o alinhamento e a posição de cada marca.
Falhas na impressão podem criar separações que não existiam no documento. Uma palavra pode parecer dividida porque uma parte da tinta desapareceu. Da mesma forma, duas letras encostadas podem ser interpretadas como uma única forma. A segmentação produz hipóteses que serão avaliadas junto do reconhecimento.
Reconhecimento de letras, números e símbolos
Ao analisar uma unidade visual, o OCR pode considerar contornos, curvas, hastes, espaços internos, pontos de junção e marcas adicionais. Uma letra maiúscula “A”, por exemplo, costuma apresentar duas hastes inclinadas e uma ligação transversal. Um número “4” pode compartilhar algumas linhas, mas possui uma configuração diferente.
Caracteres semelhantes são uma fonte comum de incerteza. A letra “O” e o número “0” podem ter formas quase idênticas. O mesmo ocorre com “I”, “l” e “1”, principalmente em fontes simples ou imagens pequenas. A sequência ao redor ajuda a escolher, mas não elimina todos os erros.
Os acentos exigem a associação entre uma marca e o corpo principal do caractere. Um til, uma cedilha ou um acento agudo pode ser interpretado como ruído, pontuação ou parte de uma letra vizinha quando a imagem está borrada ou desalinhada. Por isso, a qualidade da captura influencia diretamente a preservação da escrita em português.
Como o contexto linguístico ajuda no reconhecimento
Uma forma isolada pode admitir várias interpretações. O contexto linguístico ajuda o OCR a avaliar qual sequência de caracteres é mais compatível com o idioma e com os elementos vizinhos. Esse recurso é especialmente útil quando uma parte da letra está apagada, borrada ou encoberta.
Se uma linha produzir uma sequência parecida com “docum?nto”, o sistema pode favorecer “documento” porque essa palavra é compatível com o idioma e com a estrutura provável da frase. A escolha, porém, continua sendo uma inferência. Nomes próprios, siglas, abreviações, códigos e termos técnicos podem ser substituídos por palavras mais comuns quando a evidência visual é fraca.
O idioma configurado também influencia a interpretação. Uma combinação de letras pode ser frequente em uma língua e incomum em outra. A configuração adequada ajuda na acentuação, no vocabulário e nas regras de separação, mas não corrige uma imagem que não contém detalhes suficientes.
Modelos visuais e análise de sequências
Modelos de reconhecimento não precisam comparar cada caractere com uma única imagem fixa. Eles aprendem regularidades presentes em muitos exemplos de fontes, tamanhos e estilos. Assim, podem reconhecer uma letra mesmo quando ela aparece com pequenas variações de espessura, inclinação ou formato.
Em alguns sistemas, a análise considera sequências inteiras, e não apenas posições isoladas. Isso permite que uma forma ambígua seja avaliada junto dos caracteres vizinhos. Uma marca no meio de uma palavra pode ser interpretada de maneira diferente de uma marca idêntica em um código ou em uma tabela.
Esse mecanismo não significa que o OCR compreenda o significado do documento como uma pessoa. Ele utiliza padrões visuais e linguísticos para selecionar uma interpretação provável. Uma sequência plausível pode estar errada, especialmente quando o conteúdo original contém nomes incomuns, números ou símbolos específicos.
Como o OCR preserva a ordem e a estrutura da página
Depois de reconhecer os caracteres, o sistema precisa reunir as unidades na ordem correta. Cada região pode manter informações de posição, como coordenadas, largura, altura e relação com outros elementos. Esses dados ajudam a reconstruir linhas, palavras, parágrafos e blocos.
Em um texto comum, a leitura costuma seguir da esquerda para a direita e de cima para baixo. Em documentos com colunas, caixas, legendas e tabelas, essa regra precisa ser aplicada dentro de cada região. A saída final depende da capacidade do sistema de identificar quais elementos pertencem ao mesmo bloco.
Parágrafos e quebras de linha
O OCR pode usar a distância entre linhas, recuos e espaços verticais para diferenciar uma quebra simples de uma mudança de parágrafo. Uma linha que termina perto da margem pode continuar fazendo parte do mesmo bloco, enquanto uma área vazia maior pode indicar o início de uma nova seção.
A reprodução do layout não é necessariamente perfeita. Alguns formatos de saída preservam apenas o texto corrido, enquanto outros armazenam coordenadas, blocos e elementos visuais. Por isso, reconhecer todas as palavras não garante que a estrutura original será mantida.
Colunas e tabelas
As colunas dependem do agrupamento espacial. Em uma página com duas áreas verticais, o sistema geralmente precisa concluir a leitura de uma coluna antes de passar à outra. Se a divisão não for identificada, o resultado pode misturar linhas que estavam separadas no documento.
Tabelas são ainda mais complexas porque o significado depende da relação entre linhas e colunas. Reconhecer corretamente os termos não basta: cada conteúdo precisa permanecer associado à célula correspondente. Linhas apagadas, células mescladas, cabeçalhos irregulares e textos muito próximos podem causar deslocamentos.
Considere uma tabela com as colunas “Produto”, “Quantidade” e “Cor”. O OCR pode identificar corretamente “Caderno”, “3” e “Azul”, mas ainda precisa preservar a associação entre cada informação e sua coluna. Se a estrutura for perdida, o texto conterá as palavras, mas não representará adequadamente a organização dos dados.
Confiança, revisão e possíveis erros do OCR
O reconhecimento pode atribuir níveis de confiança às interpretações. Uma região com contornos nítidos, bom contraste e contexto compatível tende a ser considerada mais segura. Já uma palavra parcialmente coberta, um número borrado ou um símbolo isolado pode receber uma avaliação menor.
O nível de confiança não é uma garantia de acerto. Ele representa o quanto determinada hipótese combina com as evidências disponíveis. Uma palavra comum pode receber uma avaliação elevada mesmo quando o documento contém um nome próprio parecido, por exemplo.
A revisão humana continua importante em documentos que contenham:
- números, datas, valores e códigos;
- nomes próprios e endereços;
- acentos, abreviações e siglas;
- tabelas e formulários;
- caracteres visualmente semelhantes;
- texto manuscrito ou impressão desgastada.
Uma conferência eficiente pode começar pelas áreas de menor confiança e pelos elementos que têm maior impacto caso sejam alterados. Comparar a saída com a imagem original ajuda a detectar trocas como “O” por “0”, “I” por “1”, “m” por “rn” e a perda de sinais de pontuação.
O OCR também reconhece texto manuscrito?
Alguns sistemas conseguem reconhecer escrita manuscrita, mas essa tarefa costuma ser mais difícil do que a leitura de texto impresso. Na escrita à mão, cada pessoa pode variar o formato, a inclinação, o tamanho e o espaçamento das letras. Caracteres diferentes também podem ser unidos em uma mesma sequência.
Modelos preparados para escrita manuscrita podem produzir resultados úteis em determinados tipos de documento, especialmente quando a caligrafia é regular e a imagem apresenta boa qualidade. Mesmo assim, anotações pequenas, sobrepostas, apagadas ou muito abreviadas continuam sujeitas a erros.
O reconhecimento manuscrito deve ser revisado com atenção quando o conteúdo envolve nomes, números ou instruções específicas. A imagem original permanece como referência para confirmar trechos que não estejam claros.
Por que o texto pode sair fora da ordem?
A ordem final pode ficar incorreta quando o layout é complexo. O sistema pode reconhecer separadamente um título, uma legenda, uma caixa lateral e o corpo do texto, mas ter dificuldade para determinar a sequência esperada. Em páginas com colunas, uma linha pode ser inserida antes da conclusão do bloco ao qual pertence.
Esse problema é diferente de confundir uma letra. Todas as palavras podem estar corretas, mas agrupadas de maneira inadequada. Tabelas também podem apresentar palavras deslocadas, porque a reconstrução precisa preservar relações espaciais e não apenas a sequência de leitura.
Quando o resultado parece conter frases plausíveis em uma ordem estranha, vale verificar o layout original. A causa pode estar na detecção dos blocos, na leitura das colunas ou na associação entre células, e não necessariamente no reconhecimento visual dos caracteres.
Boas práticas para obter um resultado melhor
A qualidade da entrada é uma das formas mais eficazes de melhorar a conversão. Sempre que possível, fotografe ou digitalize o documento em uma superfície plana, com iluminação uniforme e sem reflexos. Mantenha a câmera alinhada ao papel e evite movimento durante a captura.
Também é recomendável preservar o arquivo original antes de aplicar filtros ou cortes. Uma cópia pode ser preparada para o OCR, enquanto a versão sem alterações permanece disponível para conferência. Isso facilita a comparação quando uma palavra ou símbolo parece ter sido interpretado de forma incorreta.
Antes de considerar o texto pronto, verifique a ordem dos blocos, os acentos, a pontuação e os números. Em tabelas, confirme se cada informação permanece na linha e na coluna corretas. Em documentos longos, a revisão pode ser orientada pelos trechos com menor confiança, quando o sistema oferecer esse recurso.
Perguntas frequentes sobre como o OCR transforma imagens em texto
O OCR entende o significado do texto?
O OCR utiliza padrões linguísticos para escolher entre possíveis interpretações, mas isso não equivale a compreender o significado do conteúdo como uma pessoa. Ele pode reconhecer uma frase provável sem verificar se as informações apresentadas são verdadeiras ou completas. Seu objetivo principal é converter formas visuais em caracteres e organizar esses caracteres.
Por que o OCR confunde letras e números?
Alguns símbolos possuem formas muito semelhantes, principalmente em imagens pequenas ou fontes simples. “O” e “0”, “I” e “1” e “l” e “I” podem ser difíceis de distinguir quando a imagem não oferece diferenças suficientes. O contexto ajuda, mas a revisão é recomendada em códigos, identificadores e números.
Uma imagem com boa aparência sempre terá um resultado perfeito?
Não. A imagem pode parecer legível para uma pessoa e ainda apresentar detalhes difíceis para o sistema, como acentos discretos, letras muito pequenas ou elementos próximos. Além disso, a estrutura de colunas e tabelas pode ser interpretada de forma incorreta mesmo quando as palavras estão nítidas.
É possível recuperar uma letra que desapareceu na imagem?
O processamento pode melhorar contraste e nitidez, mas não recupera com segurança uma informação que não foi registrada. Quando todos os sinais de um caractere desapareceram, o sistema só pode fazer uma estimativa com base no contexto. Essa estimativa deve ser conferida na fonte original ou em outra cópia do documento.
Conclusão: da representação visual ao texto pesquisável
O OCR transforma uma imagem em texto por meio de uma sequência de análises: prepara os pixels, identifica áreas de escrita, separa linhas e palavras, reconhece caracteres e reorganiza o resultado de acordo com a estrutura da página. O contexto linguístico ajuda a escolher entre formas parecidas, enquanto a posição dos elementos contribui para preservar parágrafos, colunas e tabelas.
O resultado depende da qualidade da imagem e da complexidade do documento. Contraste, resolução, iluminação, perspectiva, ruídos, fontes, acentos e organização do layout podem influenciar a precisão. Por isso, o texto extraído deve ser considerado uma conversão automatizada que pode exigir revisão, especialmente quando contém números, nomes, códigos ou informações organizadas em tabelas.
Quando a captura é feita com cuidado e as áreas mais incertas são conferidas, o OCR se torna uma forma prática de converter documentos visuais em conteúdo selecionável, pesquisável e reutilizável. A tecnologia não elimina a necessidade de validação, mas reduz significativamente o trabalho de transcrição e facilita o acesso às informações presentes em imagens.